제20장. 재해 복구: RepairService, 파티 복제(HyPR)와 LSU
동기화기를 멈추지 않고 한 노드만 고치는 법 — 계약 단위 수리(repair.*)와 repair_counter, 파티 단위 복제(Offline · Online · HyPR)와 호스팅 상태, 그리고 후속 물리 동기화기로 옮겨 가는 논리적 동기화기 업그레이드(LSU)
"모든 것은 언제나 고장 난다." — 베르너 보겔스, VLDB 2007 기조연설 대담, 빈, 2007년 9월
1. 하드포크 없는 국소 복구가 필요한 이유
2016년 이더리움(Ethereum) The DAO 해킹 사건 당시, 퍼블릭 커뮤니티는 탈취된 자금을 회수하기 위해 원장 전체의 역사를 강제로 되돌리는 하드포크(Hard Fork)를 단행했습니다. 그 결과 체인은 둘로 쪼개졌고, 수많은 거래소와 수탁기관이 이중 원장 혼란에 휩쓸렸습니다.
퍼블릭 블록체인 구조에서는 특정 기관의 스토리지 어레이 펌웨어 결함이나 스토리지 영역 네트워크(Storage Area Network, SAN)의 스플릿 브레인으로 로컬 상태 불일치(State Desynchronization)가 발생하더라도 우아한 국소 복구 수단이 없습니다. 노드를 완전히 밀어버리고 전체 블록 역사를 처음부터 재실행(Full Re-sync)하며 며칠 동안 영업을 중단하거나, 네트워크 전체의 합의를 멈춰야 합니다.
그러나 브로드리지 분산원장 레포(Broadridge Distributed Ledger Repo, DLR)처럼 대규모 환매조건부채권(Repo)이 쉬지 않고 결제되는 금융시장인프라(Financial Market Infrastructure, FMI)에서 그러한 방식은 성립할 수 없습니다. 한 은행의 스토리지가 고장 났다고 네트워크 전체를 되돌릴 수는 없습니다.
특정 참여자 노드(Participant Node)의 로컬 활성 계약 집합(Active Contract Set, ACS)이 상대방과 어긋났을 때, Canton은 동기화기(Synchronizer)를 멈추지 않고 그 노드의 로컬 상태만 고치는 수단을 둡니다. 계약 단위로 고치는 복구 명령(repair.*)과, 파티 하나의 계약 전체를 다른 참여자로 옮기는 파티 복제(Party Replication)입니다. 둘은 가드의 강도가 다르므로 이 장에서 따로 다룹니다.
repair.purge)하고 빠진 계약을 들여온(repair.import_acs) 뒤 다시 연결한다.
삽화 구성 및 생성 프롬프트 보기 (Illustration Spec & Prompt) 열기 / 닫기
2. RepairService와 repair_counter 감사 추적
복구 명령은 데이터 손상에서 회복하기 위한 최후 수단입니다. 기본적으로 꺼져 있으며, canton.features.enable-repair-commands = yes로 잠시 켠 상태에서만 동작합니다. 전형적인 순서는 disconnect → (상대 노드에서) export_acs → purge → import_acs → reconnect입니다.
synchronizers.disconnect: 고칠 노드를 동기화기에서 분리합니다.repair.purge는 해당 동기화기에서 분리된 상태이고 진행 중인 요청이 없을 때만 실행되며, 효과는 다시 연결할 때 반영됩니다.repair.export_acs(parties, ledgerOffset, …): 신뢰하는 상대 참여자에서 지정한 파티들이 이해관계자인 계약을 주어진 원장 오프셋 기준으로 GZIP 스냅샷 파일로 내보냅니다.repair.purge(synchronizerAlias, contractIds): 로컬에서 활성으로 남아 있지만 상대방은 이미 소각한 계약을 비활성화합니다.repair.import_acs(synchronizerId, importFilePath): 스냅샷의 계약을 로컬 ACS에 더합니다. 이미 활성인 계약은 건너뛰고, 이전에 purge된 계약은 다시 더할 수 있습니다.synchronizers.reconnect: 다시 연결합니다.
이 명령들은 계약 단위이고 호스팅 상태를 확인하는 가드가 없습니다. import_acs 도움말은 스냅샷이 완전하고 변조되지 않은, 신뢰하는 출처에서 왔다고 가정하며 검증은 최선 노력(best-effort)이라고 밝힙니다. 파티를 새 참여자로 옮기는 일에는 가드가 있는 파티 단위 명령(4절)을 씁니다.
데이터베이스 엔지니어라면 여기서 질문을 던질 것입니다. "기존 행을 DELETE로 지우면 누가 무엇을 고쳤는지 감사 증적이 사라지지 않습니까? 지우지 않고 같은 계약 ID와 타임스탬프로 다시 INSERT하면 기본 키 중복 오류(23505 unique_violation)가 나지 않습니까?" Canton은 par_active_contracts 테이블의 기본 키에 복구 카운터(repair_counter)를 넣어 이 문제를 풉니다.
일반 처리로 생긴 행은 최소 카운터(\(-2^{63}\))를 쓰고, 복구는 현재 clean record time \(t_{\text{clean}}\)에서 카운터 \(0, 1, 2, \dots\)를 차례로 받는다. 변경 시점은 \((\text{ts}, \text{repair\_counter})\)의 사전식 순서로 비교된다.
같은 \(t_{\text{clean}}\)에서 여러 번 복구해도 카운터가 달라 기본 키가 겹치지 않고, 이전 행은 지워지지 않습니다.
커밋먼트 누산기 LtHash16은 원소별로 \(2^{16}\)을 법으로 더하고 빼는 덧셈 해시이므로, 복구로 바뀐 \(k\)개 계약의 해시만 빼고 더하면 됩니다.
2.1 수치 추적: 소각을 놓친 계약 A와 빠진 계약 B
커밋먼트 불일치(ACS_COMMITMENT_MISMATCH)를 조사해 보니, 로컬 노드에는 순서자 시각 ts = 10500에 생성된 레포 담보 계약 A = 0x00..a7이 아직 활성으로 남아 있고(상대방은 이미 소각), 상대방에는 있는 계약 B = 0x00..b3이 로컬에 없다고 합시다. 노드를 분리한 시점의 clean record time은 t_clean = 20000입니다. par_active_contracts에는 다음 세 행이 남습니다.
| 단계 | contract_id |
ts |
repair_counter |
change |
operation |
의미 |
|---|---|---|---|---|---|---|
| 1. 일반 처리 | A |
10500 |
−263 (최소값) |
'activation' |
'create' |
합의된 트랜잭션으로 생성된 행. 복구가 아니므로 최소 카운터 |
2. repair.purge |
A |
20000 |
0 |
'deactivation' |
'purge' |
현재 clean record time에서 첫 복구. 1행은 그대로 남음 |
3. repair.import_acs |
B |
20000 |
1 |
'activation' |
'add' |
같은 시각의 두 번째 복구라 카운터 1 |
계약의 최신 상태를 읽는 쿼리는 계약마다 ts desc, repair_counter desc, change asc로 정렬해 첫 행을 고릅니다. 따라서 A는 (20000, 0)의 비활성화가, B는 (20000, 1)의 활성화가 최신 상태가 됩니다. 기존 행을 DELETE하거나 UPDATE하지 않았으므로, 감사인은 operation 열이 'purge'·'add'인 행으로 언제 무엇을 고쳤는지 확인할 수 있습니다.
운영 규칙도 두 가지 있습니다. 첫째, 복구 명령이 노출되는 관리자 API(admin-api)는 루프백 주소(127.0.0.1)나 격리된 관리망 인터페이스에만 바인딩합니다. 둘째, 메시지 크기 한도를 걱정해 서버 설정을 키울 필요는 없습니다. ExportAcs는 서버 스트리밍, ImportAcs는 클라이언트 스트리밍 RPC라 스냅샷이 여러 청크로 나뉘어 오가고, 서버 기본 max-inbound-message-size(10 MB)는 청크 하나에만 적용됩니다.
# 복구 명령은 기본 비활성. 작업 동안만 켠다.
canton.features.enable-repair-commands = yes

canton.participants.dealer_node.admin-api {
  address = "127.0.0.1"
  port = 5002
}

# --- 계약 단위 복구 순서 (콘솔) ---
# 1) participant.synchronizers.disconnect("repo-sync")
# 2) peer.repair.export_acs(parties = Set(dealerParty), ledgerOffset = off, exportFilePath = "clean-acs.gz")
# 3) participant.repair.purge("repo-sync", contractIds = Seq(cidA))
# 4) participant.repair.import_acs(syncId, importFilePath = "clean-acs.gz")
# 5) participant.synchronizers.reconnect("repo-sync")
3. DB 장애의 두 갈래: 일시적 오류는 재시도, 치명적 오류는 즉시 종료
분산 결제 인프라에서 가장 위험한 노드는 완전히 꺼진 노드가 아니라, 디스크가 망가진 줄 모른 채 반쯤 살아남아 잘못된 확인 응답을 보내는 노드입니다.
인덱싱 도중 디스크가 가득 차거나 파일시스템이 읽기 전용으로 바뀌었는데 노드가 메모리 상태만 갱신하며 버티면, 메모리 상태와 영구 저장소가 어긋납니다. Canton은 데이터베이스 예외를 재시도 정책에서 일시적(transient), 알 수 없음(unknown), 치명적(fatal) 오류로 분류하고 다르게 다룹니다.
-
일시적 오류: 짧은 네트워크 끊김이나 PostgreSQL 주-대기 절체 중의 커넥션 순단(
SQLTransientConnectionException) 같은 오류는 백오프 재시도로 흡수합니다. -
치명적 오류: 재시도로 회복할 수 없는 오류가 확인되면 노드는 처리를 이어 가지 않습니다. 노드 파라미터
exit-on-fatal-failures(기본true)가 켜져 있으면 프로세스가 종료하고, 복제(HA) 구성에서는 대기 레플리카가 잠금을 넘겨받아 활성 노드가 됩니다.
삽화 구성 및 생성 프롬프트 보기 (Illustration Spec & Prompt) 열기 / 닫기
4. 파티를 옮기는 세 가지 방법 — Offline, Online, Hybrid (HyPR)
파티 \(P\)를 새 참여자 \(T\)에도 호스팅하려면, \(T\)가 \(P\)의 ACS를 정확한 시점에 받아야 합니다. 문제는 그 시점입니다. \(T\)가 \(P\)의 호스트로 활성화된 뒤에는 \(T\)도 \(P\)의 트랜잭션을 직접 처리합니다. 스냅샷이 활성화 시점보다 늦으면 그 사이 처리된 소각·이전(unassign)이 스냅샷에 반영되지 않아, \(T\)에서 이미 소각된 계약이 되살아납니다. 스냅샷이 너무 이르면 그 사이 생성된 계약이 빠집니다. 활성화 오프셋 하나를 놓치면 ACS가 어긋납니다.
Canton은 이 시점을 고정하는 방법을 세 가지로 제공합니다.
| 방식 | 스냅샷 시점을 고정하는 수단 | 전송 경로 | 상태 |
|---|---|---|---|
| Offline (OffPR) | \(T\)의 활성화 오프셋에 정확히 맞춰 소스에서 내보냄 | 파일: parties.export_party_acs → parties.import_party_acs |
안정 |
| Online (OnPR) | Daml 관리 워크플로로 소스와 대상이 합의한 시점 | 순서자 채널 스트림: parties.add_party_async |
프리뷰. 참여자당 동시에 1건만 진행 |
| Hybrid (HyPR) | 토폴로지로 파티를 동결(freeze). 동결 구간 동안 ACS가 바뀌지 않음 | 순서자 채널 원격 읽기(설계) + Offline의 import 경로 | alpha. 토폴로지 부분만 공개 코드에 구현 |
"하이브리드"의 핵심은 스냅샷 시점을 고정하는 수단입니다. Offline은 "활성화와 정확히 같은 오프셋"을 운영자가 맞춰야 합니다. HyPR은 파티를 잠시 얼려 ACS가 변하지 않는 구간을 만들므로, 그 구간 안 어디서 읽어도 같은 스냅샷이 됩니다. 전송은 Online의 채널을, 적재는 Offline의 import 경로를 다시 씁니다.
4.1 호스팅 상태 사다리: Nominated → Freezing → Onboarding → Active
프로토콜 버전 37 동기화기에서 PartyToParticipant 매핑의 각 호스트 항목은 권한(Submission · Confirmation · Observation)과 함께 호스팅 상태를 가집니다. 상태는 Nominated < Freezing < Onboarding < Active 순서로만 전진합니다.
호스트할 수 있다고 해서 확인(confirm)할 수 있는 것은 아니다. 확인은 Active 상태의 Submission·Confirmation 권한 호스트만 한다.
FROZEN_PARTIES로 거부됩니다.
| 전이 | 서명 주체 | 효과와 가드 |
|---|---|---|
| ⊥ → Nominated | 파티 단독 | 후보 지정. Ledger API 이벤트 없음 |
| Nominated → Freezing | 참여자 단독 | 파티 동결: 호스트 집합 = ∅, 라우팅은 FROZEN_PARTIES로 거부 |
| Freezing → Onboarding | 참여자 단독 | 다른 Freezing 항목이 없으면 동결 해제. 의도된 전제는 "ACS import 완료"지만 토폴로지 검증은 이를 강제하지 않음 |
| Onboarding → Active | 참여자 단독 | parties.clear_party_onboarding_flag가 안전 시각 \(D(t_O)\) 이후에만 제안(INVARIANT 20.4) |
| 역방향 이동 | — | 서명 주체와 무관하게 거부 |
| Freezing 항목 제거 | 파티 또는 참여자 | 동결 해제(중단 경로) |
| LSU 공지 중 매핑 변경 | — | 거부. 업그레이드 시각 이후로 미룸(5절) |
온보딩 중인 호스트는 아직 확인할 수 없으므로, 중재자는 파티의 확인 임계치 \(\theta\)를 유효 임계치 \(\theta_{\text{eff}}\)로 낮춰 Active 호스트만으로도 승인이 가능하게 합니다(제12장). 대가는 일시적인 신뢰 약화입니다. 예를 들어 \(\theta = 2\)이고 호스트 하나는 Active, 하나는 Onboarding이면 \(\theta_{\text{eff}} = 1\)이 되어, 그 기간에는 Active 호스트 혼자 파티를 대신해 확인합니다. 토폴로지 관리자는 Observation이 아닌 호스트 수보다 큰 \(\theta\)를 담은 매핑 교체를 TOPOLOGY_CONFIRMING_THRESHOLD_CANNOT_BE_REACHED로 거부합니다(강제 플래그가 있고, 제거는 예외).
4.2 동결 스냅샷과 안전한 활성화 시각
기호를 정합니다. \(t_F\)는 Nominated → Freezing 매핑의 효력 시각, \(t_U\)는 Freezing 항목이 사라지는 첫 매핑의 효력 시각, \(\Delta = \text{confirmationResponseTimeout} + \text{mediatorReactionTimeout}\)(기본 30 s + 30 s = 60 s)입니다. 다음 네 가지는 코드에서 확인되는 사실입니다. (a) 시각 \(ts\)의 토폴로지 스냅샷은 \(\text{validFrom} < ts\)인 트랜잭션만 봅니다. (b) 요청은 자신의 시퀀싱 시각의 스냅샷으로 검증됩니다. (c) Freezing 항목이 있으면 호스트 집합은 비어 있습니다. (d) 확정된 요청의 record time은 시퀀싱 시각이므로, 동결 직전에 시퀀싱되고 직후에 판정된 요청은 record time \(\le t_F\)로 스냅샷에 포함됩니다.
동결 구간에 시퀀싱된 요청은 파티의 호스트가 없어 확정될 수 없으므로, 그 구간의 ACS는 동결 직후 스냅샷과 같다
증명 스케치:
- \(ts(r) > t_F\)이면 (a)·(b)에 의해 \(r\)은 동결된 매핑을 보고, (c)에 의해 확정될 수 없습니다.
- \(t_F\) 이전에 시퀀싱된 요청은 (d)에 의해 record time이 \(t_F\) 이하이고, 결정 마감 \(t_F + \Delta\) 안에 모두 판정됩니다.
따라서 소스는 자신의 clean index가 \(t_F^{+}\)를 넘을 때까지만 기다리면 됩니다. 이 성질은 코드 어디에도 한 문장으로 적혀 있지 않은, 위 네 사실을 조합한 설계 근거입니다. 동결 의미론 통합 테스트(F4: 동결 직전에 시퀀싱된 요청)가 (d)를 확인합니다.
활성화에도 같은 종류의 시각 문제가 있습니다. \(T\)가 Onboarding이 된 시각 \(t_O\) 이전에 시퀀싱된 요청은 \(T\)가 처음부터 보지 못한 요청입니다. \(T\)가 그 요청의 확인자가 되어서는 안 되므로, Onboarding → Active는 그런 요청이 모두 결정 마감을 넘긴 뒤에만 제안됩니다.
\(p\)는 \(t_O\) 이전의 동기화기 파라미터 기간이다. 활성화 제안은 관측한 동기화기 시각이 이 값을 넘은 뒤에만 나간다.
파라미터 이력 전체에서 최댓값을 취하는 이유는 \(\Delta\)가 운영 중에 바뀔 수 있기 때문입니다.
예: \(t_O = \) 12:00:00Z, 현재 \(\Delta = 60\) s이면 \(t_O + \Delta = \) 12:01:00Z. 그런데 11:59:30Z까지 유효했던 이전 파라미터의 \(\Delta = 120\) s였다면 그 기간에 시퀀싱된 요청의 마감은 12:01:30Z까지 갑니다. 따라서 \(D = \) 12:01:30Z이고, 관측 시각이 이를 넘어야 제안합니다.
구현은 \(D\) 직후 시각 증명(time proof)을 요청해 유휴 동기화기에서 오래 기다리지 않게 하고, 엄격 부등호 때문에 정확히 \(D\)에 도착한 틱이면 다시 시도하며, LSU가 공지된 동안에는 업그레이드 시각 이후로 미루고, 대기 중인 활성화 작업을 영속화해 재시작 뒤에도 이어 갑니다.
4.3 Import 가드와 운영 순서
parties.import_party_acs에 party를 지정하면 두 가드가 실행됩니다. 이 노드가 그 파티의 Onboarding 호스트로 올라 있지 않으면 PARTY_ACS_IMPORT_MISSING_ONBOARDING_MAPPING으로 거부합니다. 또 \(t_{\text{act}}\)를 효력 있는 온보딩 트랜잭션들의 validFrom 최댓값, \(rt_{\text{clean}}\)을 이 노드의 clean synchronizer index의 record time이라 할 때, 노드가 이미 활성화 이후의 이벤트를 처리했다면 PARTY_ACS_IMPORT_AFTER_ACTIVATION으로 거부합니다. 그 사이 처리된 소각과 이전을 스냅샷이 반영하지 못하기 때문입니다. 1절 첫머리의 "되살아난 계약" 사고를 막는 장치입니다.
강제 플래그 AllowImportAfterActivation는 활성화 이후 스냅샷의 어떤 계약도 소각되거나 이전되지 않았음을 운영자가 확신할 때만 씁니다.
같은 네임스페이스의 다른 파티 매핑을 읽어 활성화 시각을 잘못 계산하던 문제는 매핑 조회에서 네임스페이스 필터를 빼는 방식으로 고쳐져 있습니다.
Offline 방식의 운영 순서는 다음과 같습니다. 대상 \(T\)는 파티가 호스팅을 승인하기 전에 동기화기에서 분리해 둡니다. 그래야 활성화 이후의 이벤트를 import 전에 처리하지 않습니다.
- 매핑 제안: \(T\)가 자신을 Onboarding 호스트로 추가하는
PartyToParticipant변경에 서명합니다. 임계치가 도달 불가능하면TOPOLOGY_CONFIRMING_THRESHOLD_CANNOT_BE_REACHED. - 분리: \(T\)에서
synchronizers.disconnect. - 파티 승인: 파티(네임스페이스 소유자)가 같은 변경에 서명해 매핑이 효력을 얻습니다(\(t_{\text{act}}\)).
- 내보내기: 소스 \(S\)에서
parties.export_party_acs(party, synchronizerId, targetParticipantId = T, beginOffsetExclusive). 시작 오프셋은 활성화 토폴로지 트랜잭션보다 엄격히 앞서야 하며, 명령이 활성화 오프셋을 찾아 그 시점 스냅샷을 씁니다. - 들여오기: \(T\)에서
parties.import_party_acs(synchronizerId, party = Some(P), importFilePath). 가드 위반이면PARTY_ACS_IMPORT_MISSING_ONBOARDING_MAPPING또는PARTY_ACS_IMPORT_AFTER_ACTIVATION. - 재연결: \(T\)에서
synchronizers.reconnect. - 활성화: \(T\)에서
parties.clear_party_onboarding_flag(party, synchronizerId, beginOffsetExclusive). 결과가FlagSet(t)이면 \(D(t_O)\) 이후로 예약된 것이고, 같은 명령을 다시 호출해FlagNotSet이 될 때까지 폴링합니다.
HyPR에서는 1–3단계 앞에 파티의 지명(⊥ → Nominated)과 참여자의 동결(Nominated → Freezing)이 오고, 동결 동안 들어온 파티 관련 제출은 FROZEN_PARTIES로 거부됩니다. 스냅샷은 소스의 clean index가 \(t_F^{+}\)를 넘은 뒤 읽고, import 뒤 Freezing → Onboarding으로 동결을 풉니다.
한계
- HyPR과 Online 방식은 alpha·프리뷰 기능입니다.
- HyPR의 원격 ACS 읽기와 동결 시각 조회 RPC는 공개 소스에 없습니다. 공개 테스트는 이 부분을
repair.export_acs/import_acs로 흉내 내므로, 여기 적은 데이터 전송 경로는 설계로 읽어야 합니다. Online 방식의 순서자 채널 스트림은 구현되어 있고, 끝에 (계약 ID, 재할당 카운터)에 대한 LtHash16/BLAKE3 누산 해시를 서명한 다이제스트를 보냅니다. - HyPR에는 TLA+나 Isabelle 같은 형식 모델이 없습니다. 검증은 항목 3개 이하의 모든 상태·권한 조합과 \(\theta \in 1..4\)에 걸친 13³ × 4 = 8,788개 매핑의 소범위 전수 속성 테스트와 통합 테스트 묶음입니다.
- Freezing → Onboarding의 "import 완료" 전제를 토폴로지가 강제하지 않습니다.
- import는 소스를 신뢰하며, 검증은 최선 노력입니다.
5. LSU(Logical Synchronizer Upgrade): 후속 물리 동기화기로 옮겨 가기
글로벌 자본시장에서 '주말 정기 점검 창구'는 빠르게 사라지고 있습니다. 금요일 오후 뉴욕 채권 시장이 마감된 직후 중동과 아시아 기관들의 주말 담보 스왑이 이어지고, 월요일 새벽에는 오클랜드·시드니·도쿄·싱가포르 시장이 곧바로 문을 엽니다. 이런 시장에서 수십 개 기관의 노드를 한꺼번에 끄고 프로토콜 버전을 올리는 일제 셧다운은 현실적이지 않습니다.
Canton의 논리적 동기화기 업그레이드(Logical Synchronizer Upgrade, LSU)는 하나의 논리적 동기화기를 이루는 물리 동기화기(순서자·중재자 노드 묶음)를 후속(successor) 물리 동기화기로 교체합니다. 순서는 다음과 같습니다.
- 공지: 동기화기 소유자들이
LsuAnnouncement토폴로지 매핑(후속 물리 동기화기 ID, 업그레이드 시각 \(t_{\text{up}}\))을 승인합니다. 공지가 효력을 얻은 뒤에는 업그레이드 관련 토폴로지 변경만 허용되며, 파티 호스팅 매핑 변경도 거부됩니다. - 후속 노드 준비: 운영자는 새 프로토콜 버전(현재 안정 버전은 36과 37)으로 후속 순서자·중재자를 띄우고, 순서자는 선행 동기화기의 상태로 초기화합니다(
initialize_from_lsu_predecessor). 후속 순서자 접속 정보는 별도 토폴로지 매핑으로 공표됩니다. - 전환: \(t_{\text{up}}\)이 지나면 참여자는 후속 물리 동기화기에 연결합니다. 기본은 자동이며, 수동 경로(
perform_manual_lsu)와 늦게 합류한 참여자를 위한 복구 경로(repair.perform_late_lsu)가 있습니다.
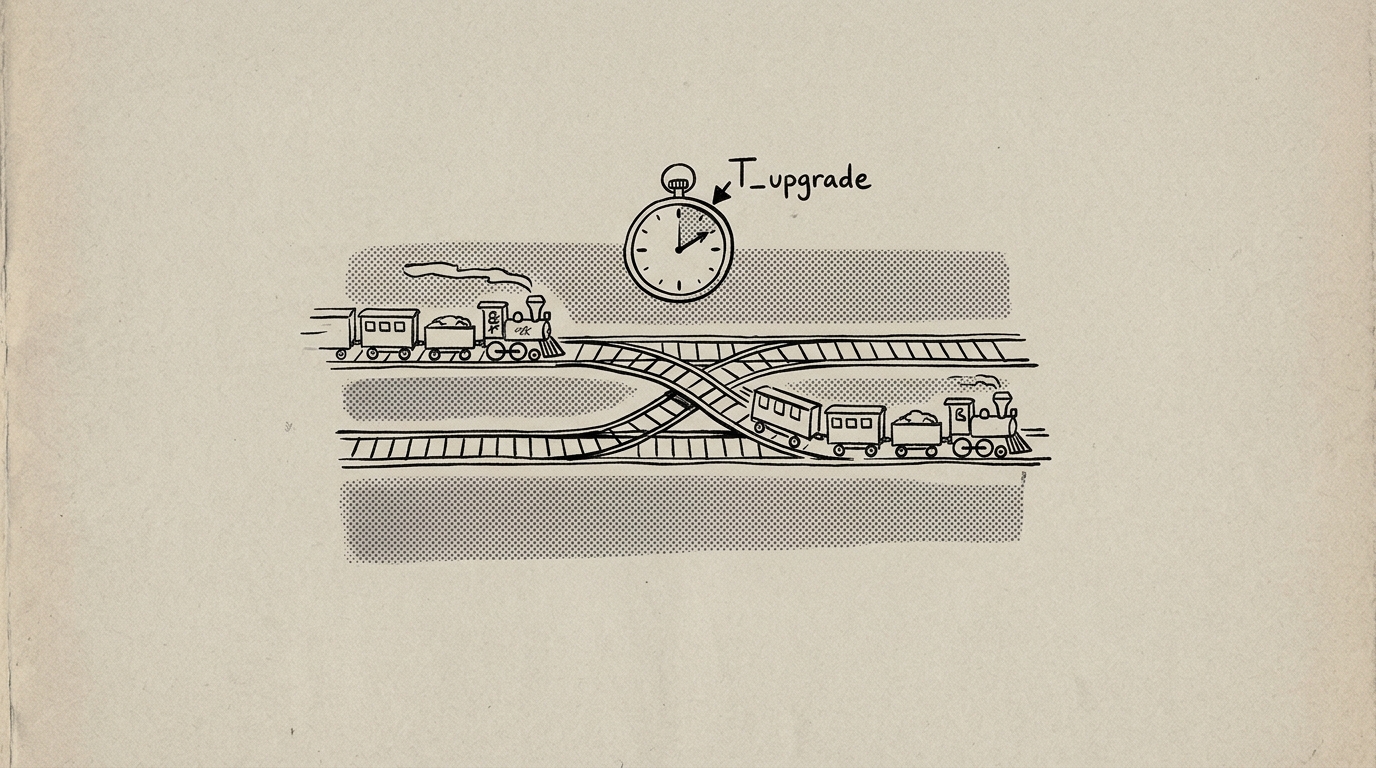
논리적 동기화기 ID와 계약은 그대로입니다. 후속 동기화기의 시퀀싱 시각은 모두 \(t_{\text{up}}\)보다 크고, 참여자는 요청 카운터를 처음부터 다시 셉니다. 선행 동기화기에서 진행 중이던 요청은 후속 동기화기로 넘어가지 않습니다.
삽화 구성 및 생성 프롬프트 보기 (Illustration Spec & Prompt) 열기 / 닫기
업그레이드 시각을 가로지르는 요청은 어느 쪽에서도 확정되지 않는다
commandId와 중복제거 기간으로 다시 제출합니다(제19장).
5.1 밀리초 추적: \(t_{\text{up}}\) = 2026-11-15T00:00:00.000Z 경계의 두 거래
일요일 자정 UTC에 업그레이드가 예정되어 있다고 합시다(예시 시각). 자정 전후에 제출된 두 건의 국경 간 레포 거래 Tx_A와 Tx_B를 따라갑니다.
-
Tx_A(선행 동기화기에서23:59:59.980Z에 시퀀싱): 싱가포르 딜러의 레포 결제 요청입니다. 확인 응답을 모아 판정이 나올 시각은 자정을 넘긴00:00:00.045Z입니다. 선행 동기화기는 \(t_{\text{up}}\) 이후 판정을 내리지 않으므로Tx_A는 확정되지 않고 타임아웃으로 끝납니다. 제출 애플리케이션은 타임아웃 완료를 받고, 후속 동기화기에 같은commandId로 다시 제출합니다. -
Tx_B(후속 동기화기에서 시퀀싱): 자정 직후 도쿄 은행이 제출한 거래는 후속 동기화기에서 \(t_{\text{seq}} > t_{\text{up}}\)인 시각을 받고, 새 프로토콜 버전의 규칙으로 검증·확정됩니다.
5.2 애플리케이션 개발자를 위한 LSU 재구독과 Daml 계약 불변성
LSU나 복구 작업이 진행되어도 Daml 계약 코드와 ContractId는 바뀌지 않습니다. 클라이언트는 마지막으로 처리한 원장 오프셋을 체크포인트로 기록해 두었다가, 레플리카 절체나 LSU 전환 중 gRPC UNAVAILABLE을 받으면 그 오프셋 다음(beginExclusive)부터 스트림을 다시 구독하면 됩니다.
// LSU 전환이나 레플리카 절체로 생긴 gRPC 순단 뒤 마지막 오프셋부터 이어받는 클라이언트
export async function streamRepoSettlementsResiliently(
  updateService: UpdateServiceClient,
  checkpointStore: OffsetCheckpointStore,
  party: string
): Promise<void> {
  while (true) {
    const lastCommittedOffset = await checkpointStore.loadLastOffset();
    try {
      const stream = updateService.getUpdates({
        beginExclusive: lastCommittedOffset, // 처리와 오프셋 기록을 한 트랜잭션으로 묶어 중복·누락 방지
        filter: { filtersByParty: { [party]: {} } },
      });
      for await (const update of stream) {
        await checkpointStore.processAtomicallyWithOffset(update, update.offset);
      }
    } catch (err: any) {
      // 일시적 UNAVAILABLE(14)은 재연결
      if (err.code === 14) {
        await sleepWithJitterMs(250);
        continue;
      }
      throw err;
    }
  }
}-- 물리 동기화기가 후속 노드로 바뀌거나 복구 명령을 거쳐도
-- ContractId와 서명자 권리·의무는 그대로 남는다.
template CrossBorderRepo
with
cashLender : Party
bondBorrower : Party
ustCusip : Text
principalUsd : Decimal
repurchaseAmountUsd : Decimal
where
signatory cashLender, bondBorrower
choice RollOverWeekend : ContractId CrossBorderRepo
with newRepurchaseAmountUsd : Decimal
controller cashLender, bondBorrower
do
create this with repurchaseAmountUsd = newRepurchaseAmountUsd6. 장애 시나리오 매트릭스와 PFMI 업무연속성 기준
정책 결정자와 최고위험관리책임자(CRO)가 감독당국에 재해복구 구조를 설명할 수 있도록, 장애·변경 시나리오별 대응 절차와 목표치를 정리했습니다. RPO·RTO 값은 운영 목표의 예시이며, 실제 값은 배포 구성과 연습 결과로 확인해야 합니다.
| 장애 및 변경 시나리오 | 대응 절차 | 목표 RPO (예시) | 목표 RTO (예시) | 감사 추적 |
|---|---|---|---|---|
| 1. 복제(HA) 참여자의 활성 레플리카 장애 | 대기 레플리카가 DB 잠금을 넘겨받아 활성화. 클라이언트는 오프셋부터 재구독 | 0 | 수 초 ~ 수십 초 | 원장 오프셋 연속성 |
| 2. 국소 ACS 불일치 | 계약 단위 복구 (disconnect → export_acs → purge → import_acs → reconnect) |
0 | 수십 분 (계약 수에 비례) | repair_counter·operation 행, 커밋먼트 재일치 |
| 3. 노드 교체·파티 이전 | 파티 복제(Offline · Online · HyPR)와 import 가드 | 0 | 스냅샷 크기에 비례 | 호스팅 상태 전이 토폴로지 기록 |
| 4. 프로토콜 버전 업그레이드 (LSU) | 후속 물리 동기화기 준비 후 \(t_{\text{up}}\)에 연결 전환 | 0 (경계 요청은 타임아웃 후 재제출) | 전환 지연 수준 | LsuAnnouncement 토폴로지 기록 |
| 5. 주 데이터센터 전면 정전 | 동기식 복제 DB 승격 후 다른 순서자 엔드포인트로 재접속 | 0 (동기식 복제 시) | 15분 내외 | 순서자 서명 이벤트, 커밋먼트 일치 |
CPMI-IOSCO 「금융시장인프라 원칙(PFMI)」 원칙 17(운영 리스크)은 업무연속성계획이 중대한 장애 뒤 핵심 IT 시스템을 2시간 안에 재가동하고, 극단적 상황에서도 당일 안에 결제를 마칠 수 있도록 설계될 것을 요구합니다. 유럽연합의 디지털 운영 회복탄력성 법(DORA, Regulation (EU) 2022/2554)과 바젤은행감독위원회(BCBS) 「운영 회복탄력성 원칙」도 단일 기관의 장애나 소프트웨어 변경이 시장 전체의 정지로 번지지 않는 격리 구조를 요구합니다.
위 매트릭스의 핵심은 회복 경로가 네트워크 전체를 멈추지 않는다는 점입니다. 한 노드의 어긋난 계약만 고치고, 파티를 가드가 있는 절차로 옮기며, 프로토콜 버전은 물리 동기화기를 교체해 올립니다. 각 경로의 대가(경계 요청의 재제출, 온보딩 동안의 신뢰 약화, 복구 명령의 신뢰 가정)도 함께 문서화해 두어야 감독당국 앞에서 설명할 수 있습니다.
이 장에서 남는 것
- 복구 카운터와 감사 추적. 일반 행은 최소 카운터를, 복구는 현재 clean record time에서 카운터 0, 1, 2…를 받으므로 기존 행을 지우지 않고 기본 키 충돌 없이 고칠 수 있다. 최신 상태는
(ts, repair_counter)순서로 정해진다. - 계약 단위와 파티 단위를 구분한다.
repair.export_acs/import_acs/purge는 가드 없는 최후 수단이고, 파티 이전은parties.export_party_acs/import_party_acs와 import 가드(INVARIANT 20.5)를 쓴다. - 호스팅 상태와 두 개의 시각. Nominated → Freezing → Onboarding → Active 사다리에서, 동결은 스냅샷 시점을 고정하고(INVARIANT 20.3, 설계 근거), 활성화는 \(D(t_O)\) 이후에만 일어난다(INVARIANT 20.4). HyPR의 원격 읽기는 공개 소스에 없는 alpha 설계다.
- 치명적 오류는 멈춘다. 일시적 DB 오류는 재시도하고, 회복할 수 없는 오류는
exit-on-fatal-failures로 노드를 멈춰 대기 레플리카에 넘긴다. - LSU는 물리 동기화기 교체다. 후속 동기화기의 시퀀싱 시각은 모두 \(t_{\text{up}}\) 이후이고, 업그레이드 시각에 진행 중이던 요청은 타임아웃으로 끝나 재제출된다(INVARIANT 20.6).