특별 부록. Canton 운영 엔지니어링 노트 — 내부 구조, 용량 산정, 장애 대응
프로덕션 participant·synchronizer 노드를 설계하고 운영하는 아키텍트와 SRE를 위한 레퍼런스
"복잡한 시스템은 고장난 채로 돌아간다. 그렇게 많은 중복이 있고, 사람이 결함 속에서도 시스템을 돌아가게 할 수 있기 때문이다." — 리처드 쿡, 「복잡한 시스템은 어떻게 실패하는가」 제5항
본편은 Canton과 Daml이 무엇을 보장하는지를 설명했습니다. 이 부록은 그 보장을 실제 노드에서 유지하는 일을 다룹니다. 대상 독자는 participant(참여자 노드)와 synchronizer(동기화기)를 구성하는 순서자·중재자를 직접 설계하고 운영하는 아키텍트와 SRE입니다. 다루는 질문은 세 가지입니다. 노드 내부에서 데이터가 어떻게 저장되고 검사되는가, 설정값을 어떤 근거로 정하는가, 장애가 났을 때 어떤 순서로 무엇을 확인하는가.
본문에 나오는 기본값, 오류 ID, 설정 키, 콘솔 명령은 본서의 기준 버전(머리말 참조) 소스에서 확인한 것입니다. 기본값은 릴리스마다 바뀔 수 있으므로, 운영 환경에 적용하기 전에는 사용하는 릴리스의 설정 레퍼런스와 콘솔 help 출력을 다시 확인하십시오. 처리량, 지연, 비용처럼 환경에 따라 달라지는 수치는 싣지 않았습니다. 산정 예시에 나오는 숫자는 모두 전제를 밝힌 예시 수치이고, 측정값이 아닙니다.
이 부록을 읽는 방법
부록은 여섯 묶음으로 나뉩니다. 앞의 세 묶음(A.1–A.3)은 설계할 때 읽는 내용이고, 뒤의 세 묶음(A.4–A.6)은 운영 중에 찾아보는 내용입니다. 각 절은 아래 여섯 항목을 같은 순서로 씁니다. 해당 사항이 없는 항목은 생략합니다.
| 항목 | 담는 내용 |
|---|---|
| 맥락 | 언제 문제가 되는가, 어떤 증상으로 나타나는가 |
| 메커니즘 | 노드가 실제로 하는 일(테이블, 자료구조, 프로토콜 단계) |
| 설정 | 설정 키, 기본값, 바꿀 때의 근거 |
| 산정 | 공식과 전제를 밝힌 예시 계산 |
| 실패 양상 | 오류 ID, 관측되는 현상 |
| 런북 | 콘솔 명령과 확인 순서 |
| 묶음 | 절 | 주 독자 |
|---|---|---|
| A.1 내부 구조 | 저장 구조, 충돌 감지, 인덱서, ACS commitment, 워터마크, time proof, 중복 제거, repair 기록, 노드별 관측 데이터 | 아키텍트 · 백엔드 · DBA |
| A.2 용량·성능 산정 | DB 연결 풀, 팬아웃 버퍼와 캐시, ack 주기와 순서자 보존량, API 한도, BFT 노드 수, 트래픽 예산 | 아키텍트 · SRE |
| A.3 보안·키 관리 | KMS 연동, 세션 서명 키와 암호화 키 캐시, 노드 키 교체, API 노출과 토큰 검증, 외부 서명 당사자 | 보안 · SRE |
| A.4 운영 런북 | 디스크 가득 참, 프루닝 후 bloat, 순서자 프루닝 정지, participant 프루닝 정지, 미완료 재할당, 시간 경계 거부, vetting 오류, HA 페일오버, repair | SRE · DBA |
| A.5 관측성과 분류 | health.dump, health 엔드포인트, 스토리지 장애 상태, 분류 매트릭스, 감사 증적 |
SRE · 리스크 |
| A.6 업그레이드와 배포 선택 | LSU, 배포 모델, 토큰 없는 비용 모델, Splice 구성요소, 저장소·순서화 계층의 변천, 4노드 BFT 실습, 적용 사례 | 아키텍트 · CTO |
A.1 내부 구조
이 묶음은 participant와 순서자가 상태를 저장하고 검사하는 방식을 다룹니다. 설정을 바꾸거나 장애를 분석할 때 근거가 되는 내용입니다. 스키마와 자료구조 수준에서 설명하며, 이름이 나오는 테이블과 열은 PostgreSQL 마이그레이션 스크립트에 있는 그대로입니다.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
A.1.1 저장 구조: 이미 압축된 이벤트의 TOAST 전략, change_type 순서, 단일 행 테이블
맥락. Canton은 운영 저장소로 PostgreSQL을 씁니다. 스키마에는 PostgreSQL의 저장 방식에 맞춘 선택이 몇 가지 들어 있습니다. 이 선택들을 알아야 테이블 크기, 프루닝 질의, 수동 진단 SQL을 올바르게 읽을 수 있습니다.
메커니즘 1: 압축을 건너뛰는 열. PostgreSQL은 행 크기가 약 2KB를 넘으면 TOAST를 적용하고, BYTEA 열의 기본 전략(EXTENDED)은 행 밖으로 옮기기 전에 압축을 먼저 시도합니다. 순서자 클라이언트가 받은 이벤트를 저장하는 common_sequenced_events의 sequenced_event 열에는 이미 압축된 protobuf 메시지가 들어가고, 그 안의 뷰는 암호화되어 있습니다. 이런 바이트열은 다시 압축해도 줄지 않으므로, 스키마는 이 열을 EXTERNAL로 지정해 압축 시도 자체를 생략합니다.
-- 스키마 주석: "Disable Postgres compression; the proto message is already compressed"
ALTER TABLE common_sequenced_events
  ALTER COLUMN sequenced_event SET STORAGE EXTERNAL;
두 가지를 구분해 두십시오. 첫째, common_sequenced_events는 순서자의 이벤트 저장소가 아니라 순서자 클라이언트(participant, 중재자)가 자신이 받은 이벤트를 보관하는 테이블입니다. 둘째, 기준 버전 스키마에서 EXTERNAL 지정은 이 열 하나에만 있습니다. 계약 인스턴스를 담는 par_contracts에는 이 지정이 없습니다. 다른 열에 같은 설정을 직접 적용하려면, 대상 열의 실제 압축률을 먼저 측정하십시오. 효과는 페이로드 크기 분포와 압축 알고리즘에 따라 달라집니다.
메커니즘 2: change_type 열거형의 선언 순서. 활성 계약 집합(ACS)의 변경 이력은 par_active_contracts에 한 변경당 한 행으로 쌓입니다. 변경 종류를 나타내는 열거형은 'deactivation'을 먼저 선언합니다. PostgreSQL 열거형은 선언 순서대로 정렬되므로, deactivation < activation이 됩니다.
-- activation: create, assign / deactivation: archive, unassign
CREATE TYPE change_type AS ENUM ('deactivation', 'activation');
CREATE TYPE operation_type AS ENUM
  ('create', 'add', 'assign', 'archive', 'purge', 'unassign');

CREATE TABLE par_active_contracts (
  synchronizer_idx        INTEGER        NOT NULL,
  contract_id             BYTEA          NOT NULL,
  change                  change_type    NOT NULL,
  operation               operation_type NOT NULL,
  ts                      BIGINT         NOT NULL,  -- 마이크로초 단위 UTC
  repair_counter          BIGINT         NOT NULL,  -- repair가 아닌 변경은 최솟값
  remote_synchronizer_idx INTEGER,
  reassignment_counter    BIGINT DEFAULT NULL,
  PRIMARY KEY (synchronizer_idx, contract_id, ts, repair_counter, change)
);
이 순서의 목적은 스키마 주석에 적혀 있습니다. 같은 타임스탬프에 한 계약의 비활성화와 다른 계약의 활성화가 함께 기록되는 일은 흔합니다(한 트랜잭션이 계약을 보관하고 새 계약을 만드는 경우). 이때 (ts, change) <= (bound, 'deactivation')이라는 행 비교 하나로 "경계 시각까지의 변경 중, 경계 시각에서는 비활성화만"을 고를 수 있습니다. 같은 (ts, repair_counter)에서 정렬할 때도 비활성화가 활성화보다 먼저 옵니다. 프루닝은 계약별로 (ts, repair_counter)를 그 계약의 비활성화 시점과 비교하므로, 수동 진단 SQL을 쓸 때도 이 순서를 전제로 하십시오.
메커니즘 3: 단일 행 테이블. "값이 하나만 있어야 하는 상태"는 한 행만 허용하는 테이블로 저장합니다. 순서자의 읽기 하한(sequencer_lower_bound)과 BFT 순서화 계층의 출력 하한(ord_output_lower_bound)이 이 방식을 씁니다.
-- 이 시각 이전의 이벤트는 프루닝되어 더는 읽을 수 없다(exclusive lower bound)
CREATE TABLE sequencer_lower_bound (
  single_row_lock CHAR(1) NOT NULL DEFAULT 'X'
    PRIMARY KEY CHECK (single_row_lock = 'X'),
  ts BIGINT NOT NULL,
  latest_topology_client_timestamp BIGINT
);
기본 키가 중복을 막고 CHECK가 'X' 외의 값을 막으므로, 이 테이블에 들어갈 수 있는 행은 최대 하나입니다. 두 번째 행을 넣으려는 시도는 23505(unique_violation)나 23514(check_violation)로 실패합니다. 애플리케이션 버그나 중복 실행된 프로세스가 하한을 두 개로 만드는 상태를 스키마 수준에서 표현할 수 없게 한 것입니다.
런북. 테이블별 크기와 TOAST 비중은 A.4.2의 진단 SQL로 확인합니다. Canton 테이블의 행을 SQL로 직접 수정하지 마십시오. ACS를 고쳐야 하면 A.4.9의 repair 명령을 씁니다.
A.1.2 충돌 감지: 계약별 세 카운터와 잠금
맥락. 같은 계약을 소비하려는 요청 두 개가 거의 동시에 들어오면 하나만 성공해야 합니다. 한편 같은 계약을 읽기만 하는 요청은 서로를 막으면 안 됩니다. participant의 충돌 감지기(conflict detector)가 이 구분을 맡습니다. 애플리케이션에서는 LOCAL_VERDICT_LOCKED_CONTRACTS나 LOCAL_VERDICT_INACTIVE_CONTRACTS 거부로 관측됩니다.
메커니즘. 충돌 감지기는 검사 중인 계약마다 세 개의 포화(saturating) 카운터를 메모리에 둡니다.
| 카운터 | 증가 시점 | 감소 시점 |
|---|---|---|
| lock | 계약을 소비하는 요청의 활성 검사(activeness check)가 실행될 때 | 요청이 종결될 때(커밋, 거부, 타임아웃) |
| pendingActivenessChecks | 검사 대상 계약으로 등록될 때 | 활성 검사가 끝날 때 |
| pendingWrites | 요청이 종결되어 잠금이 풀릴 때 | 결과가 DB에 기록된 뒤 |
lock은 0과 1만 갖는 플래그가 아니라 카운터입니다. 활성 검사에서 계약이 "활성"으로 판정되는 조건은 세 가지를 모두 만족하는 것입니다. 계약이 알려져 있고, 잠겨 있지 않고, 상태가 active여야 합니다. 이미 잠긴 계약을 소비하려는 두 번째 요청은 LOCAL_VERDICT_LOCKED_CONTRACTS로 거부됩니다. 이미 보관된 계약을 쓰려는 요청은 LOCAL_VERDICT_INACTIVE_CONTRACTS로 거부됩니다. 비소비(nonconsuming) 사용은 활성 여부만 검사하고 잠그지 않으므로, 같은 계약을 참조만 하는 요청끼리는 서로 거부하지 않습니다.
잠금은 요청이 종결될 때까지 유지됩니다. 종결 시한은 판정 시각(decision time)이고, 기본 동적 파라미터에서는 시퀀싱 시각으로부터 60초입니다(A.1.9). 따라서 응답하지 않는 확인자가 있으면 그 요청이 잡은 계약은 최대 그 시간만큼 잠긴 채로 남습니다.
template MasterRepoLine
  with
    dealer       : Party
    counterparty : Party
    maxLimitUsd  : Decimal
  where
    signatory dealer, counterparty

    -- nonconsuming: 활성 여부만 검사하고 잠그지 않는다.
    -- 같은 계약을 참조하는 동시 요청끼리 서로 거부하지 않는다.
    nonconsuming choice VerifyRepoTicket : ()
      with ticketUsd : Decimal
      controller counterparty
      do
        assertMsg "Ticket exceeds master repo limit" (ticketUsd <= maxLimitUsd)

    -- consuming: 활성 검사 시점에 잠금을 잡는다.
    -- 종결 전에 도착한 두 번째 소비 요청은 LOCAL_VERDICT_LOCKED_CONTRACTS.
    choice CloseMasterLine : ()
      controller dealer
      do return ()
실패 양상. 경합이 잦은 계약(공용 카운터, 단일 잔고 계약)을 매 요청이 소비하도록 모델링하면 LOCAL_VERDICT_LOCKED_CONTRACTS 비율이 높아집니다. 이 오류는 노드 이상이 아니라 모델과 워크로드의 경합을 나타냅니다. 대응은 재시도 정책과 모델 분할(읽기 전용 참조로 바꾸기, 계약을 잘게 나누기)입니다.
런북. 카운터는 메모리 상태이므로 DB에서 조회할 수 없습니다. 노드를 재시작하면 마지막 clean 지점 이후의 이벤트를 다시 처리하면서 잠금 상태를 재구성합니다. 특정 계약이 계속 잠긴 것처럼 보이면, 그 계약을 쓰는 미결 요청이 판정 시각을 넘겼는지와 동기화기 연결 상태를 먼저 확인하십시오.
A.1.3 인덱서 파이프라인과 잠금 획득 순서
맥락. 병렬 인덱서는 확정된 변경을 Ledger API용 테이블에 기록합니다. 인덱서가 밀리면 Ledger API 스트림과 완료(completion) 응답이 늦어집니다. 인덱서와 프루닝이 같은 계약 행을 동시에 건드릴 수 있으므로 둘 사이의 조율도 필요합니다.
메커니즘. 인덱서는 일곱 개 안팎의 단계로 이루어진 파이프라인입니다. 입력 매핑, DB용 데이터 준비, 배치 구성, 적재(ingestion), 후처리가 각각 정해진 병렬도로 실행됩니다. 계약 행의 잠금은 FOR KEY SHARE로 잡고, 잠금 순서는 정수형 internal_contract_id 오름차순으로 고정합니다. 여러 세션이 여러 행을 잠글 때 순서가 서로 다르면 PostgreSQL이 교착(40P01)을 감지해 한쪽을 중단시킵니다. 모든 세션이 같은 순서로 잠그면 대기 관계에 순환이 생기지 않습니다. 이 순서 고정은 인덱서와 프루닝 사이의 조율 수단입니다.
설정. 주요 기본값은 다음과 같습니다.
| 항목 | 기본값 |
|---|---|
| submission batch size | 50 |
| 최대 입력 버퍼(업데이트 수) | 50 |
| 입력 매핑 병렬도 | 16 |
| DB 준비 병렬도 | 4 |
| 적재(ingestion) 병렬도 | 16 |
| 후처리 병렬도 | 8 |
| tailer 최대 배치 크기 | 10 |
산정. 인덱서는 자체 DB 풀을 씁니다. 기본 크기는 적재 16 + DB 준비 4 + 2 = 22개 연결입니다. 이 값은 A.2.1의 participant 풀과 별도로 PostgreSQL의 max_connections에 더해야 합니다.
실패 양상. 로그에 40P01이 반복되면 Canton 바깥의 세션(수동 SQL, 외부 유지보수 작업)이 같은 테이블을 잠그고 있는지 확인하십시오. 인덱서와 프루닝만으로는 잠금 순서가 일치합니다.
A.1.4 ACS commitment: LtHash16 누적과 교환 다이제스트
맥락. 두 participant가 공유하는 계약 집합이 서로 같은지 주기적으로 대조해야 합니다. 어긋나면 ACS_COMMITMENT_MISMATCH가 보고됩니다. 이 대조는 participant 프루닝의 경계도 결정합니다(A.4.4).
메커니즘. 안정 프로토콜 버전은 LtHash16(BLAKE3 기반)으로 계약 집합의 누적 해시를 유지합니다. 각 원소는 계약 ID, 재할당 카운터, 정렬된 당사자 쌍을 입력으로 삼아 BLAKE3 확장 출력으로 2,048바이트를 만들고, 이를 16비트 정수 1,024개의 벡터로 해석합니다. 계약이 활성화되면 벡터를 원소별로 더하고, 비활성화되면 뺍니다. 연산은 \(2^{16}\)을 법으로 합니다. 덧셈과 뺄셈이 서로 역이므로, 집합 전체를 다시 해시하지 않고 변경분만 반영할 수 있습니다.
예시 수치(한 원소만 추적).
- 누적값이 45,000일 때 해당 원소값이 30,000인 계약이 활성화되면 \((45{,}000 + 30{,}000) \bmod 65{,}536 = 9{,}464\)가 됩니다.
- 그 계약이 비활성화되면 \((9{,}464 - 30{,}000) \bmod 65{,}536 = 45{,}000\)으로 돌아옵니다.
구현은 JVM의 부호 있는 16비트 정수에 결과를 잘라 넣는 방식(toShort)을 쓰는데, 하위 16비트만 남기므로 \(2^{16}\)을 법으로 한 연산과 같습니다.
누적은 당사자별, 상대 participant별로 유지합니다. 상대와 교환하는 값은 2,048바이트 벡터 자체가 아니라 그 벡터의 SHA-256 다이제스트입니다(34바이트 multihash 형식). commitment 메시지에는 동기화기, 송신자, 상대 participant, 구간 (fromExclusive, toInclusive], 다이제스트가 들어가고, 서명은 이를 감싸는 프로토콜 메시지에 붙습니다. 계산 결과는 par_computed_acs_commitments에 저장됩니다.
설정. 대조 주기는 동기화기 동적 파라미터 reconciliationInterval이고 기본값은 60초입니다.
실패 양상. commitment는 상대 participant 쌍마다 계산되므로, 대사 작업이 자동화될 뿐 없어지지는 않습니다. ACS_COMMITMENT_MISMATCH는 두 participant가 그 구간 끝 시점에 공유 계약 집합을 다르게 보고 있다는 뜻입니다. 원인은 한쪽의 repair 작업, 프루닝된 데이터에 대한 불일치, 버그 등입니다. 상대가 commitment를 보내지 않으면 불일치가 아니라 프루닝 정지로 나타납니다(A.4.4).
런북. 주고받은 commitment는 participant.commitments.lookup_sent_acs_commitments와 lookup_received_acs_commitments로 조회합니다. 불일치가 확인되면 양쪽 운영자가 어느 계약이 다른지 합의한 뒤 A.4.9의 repair로 맞춥니다.
A.1.5 워터마크: PeanoQueue와 clean index
맥락. 병렬 처리에서는 작업이 시작한 순서대로 끝나지 않습니다. 104번이 먼저 끝났다고 "104번까지 처리했다"고 알리면, 102번이 실패했을 때 복구 시작점이 틀어집니다. 노드가 외부에 알리는 진행 지점은 빈틈없이 연속으로 끝난 구간의 끝이어야 합니다.
메커니즘. PeanoQueue는 일련번호가 붙은 항목을 순서 없이 받아 두고, head 바로 다음 번호가 들어왔을 때만 head를 전진시키는 자료구조입니다. head가 100일 때 103과 104가 먼저 도착하면 큐에 보관만 하고, 101과 102가 도착한 뒤에야 head가 104까지 한 번에 이동합니다. Canton은 BFT 순서화 계층의 출력 모듈에서 블록을 순서대로 내보낼 때와, 중재자·순서자 클라이언트가 clean 카운터를 추적할 때 이 구조를 씁니다. participant가 순서자에 보내는 ack는 Ledger API의 clean synchronizer index에서 나옵니다.
실패 양상. 처리 지점이 전진하지 않으면 한 항목이 끝나지 않고 있다는 뜻입니다. 뒤의 항목이 아무리 많이 끝나도 워터마크는 그 앞에서 멈춥니다. 이 상태가 지속되면 ack가 늦어지고, 순서자 쪽 보존량이 늘어납니다(A.2.3).
A.1.6 유휴 동기화기의 시간 진행: time proof
맥락. participant가 아는 동기화기 시각은 순서자가 이벤트에 붙인 타임스탬프뿐입니다. 이벤트가 없으면 participant가 관측하는 시각도 전진하지 않습니다. 그러면 시각에 의존하는 처리(타임아웃 판정, 주기적 commitment, 토폴로지 유효 시점 확인)가 유휴 시간대에 멈춥니다.
메커니즘. 동기화기 시간 추적기(time tracker)는 필요한 시각이 정해진 지연 안에 관측되지 않으면 순서자에 time proof를 요청합니다. time proof는 내용 없이 타임스탬프만 얻기 위한 이벤트입니다. 요청은 single-flight입니다. 원자적 참조에 대한 compareAndSet으로 "이미 요청이 나가 있는지"를 확인하므로, 여러 컴포넌트가 동시에 시각을 기다려도 요청은 하나만 나갑니다. 원장 시각(ledger time)은 이와 별개입니다. 제출자가 고르고, 사용한 계약들의 원장 시각 중 최댓값 이상으로 올립니다.
설정. 시간 추적기는 노드 전역 설정이 아니라 동기화기 연결마다 있는 설정(timeTracker)입니다. 연결을 등록하거나 수정할 때 지정합니다.
| 필드 | 기본값 | 의미 |
|---|---|---|
observationLatency | 250ms | 호스트 시각이 다음 기대 시각을 이만큼 넘기면 time proof를 요청 |
patienceDuration | 500ms | 마지막 이벤트를 받은 뒤 이 시간이 지나야 요청(이벤트가 계속 들어오는 동안에는 요청하지 않음) |
minObservationDuration | 24h | 이 기간마다 적어도 한 번은 시각을 받도록 함. 유휴 동기화기에서도 ack할 이벤트가 생기므로 순서자 프루닝이 진행됨 |
실패 양상. 값을 지나치게 줄이면 유휴 동기화기에도 time proof 요청이 계속 나가고, 그만큼 트래픽을 소비합니다(A.2.6). 값을 지나치게 늘리면 타임아웃 처리와 commitment가 늦어집니다.
A.1.7 명령 중복 제거와 프루닝 경계
맥락. 클라이언트는 응답을 받지 못하면 같은 명령을 다시 보냅니다. participant는 중복 제거 기간 안의 같은 change ID(사용자, 명령 ID, actAs 집합)를 한 번만 받아들입니다. 문제는 프루닝입니다. 이미 지운 구간에 그 명령이 있었는지는 확인할 수 없습니다.
메커니즘. 클라이언트가 요청한 중복 제거 기간이 프루닝된 구간까지 거슬러 올라가면, participant는 "기록이 없으니 중복이 아니다"라고 판단하지 않고 요청을 거부합니다.
\(t_{\text{pub}}\)는 마지막 게시(publication) 시각, \(\Delta_{\text{dedup}}\)는 요청한 중복 제거 기간, \(t_{\text{pruned}}\)는 프루닝된 게시 시각입니다.
조건을 만족하지 못하면 INVALID_DEDUPLICATION_PERIOD로 거부되고, 오류 메타데이터에 허용되는 범위(가장 이른 오프셋 또는 최대 기간)가 실립니다.
설정. participant가 허용하는 최대 중복 제거 기간은 participant 프루닝의 하한 중 하나입니다. 이 기간보다 최근 데이터는 find_safe_offset이 안전하다고 보지 않습니다. 따라서 보존 기간은 "클라이언트가 재시도를 포기하기까지 걸리는 최대 시간"보다 길게 잡아야 합니다.
실패 양상. INVALID_DEDUPLICATION_PERIOD가 프루닝 직후부터 나타나면 클라이언트의 중복 제거 기간이 보존 기간보다 깁니다. DUPLICATE_COMMAND는 같은 change ID가 기간 안에 이미 수락되었다는 뜻이고, SUBMISSION_ALREADY_IN_FLIGHT는 같은 명령이 아직 처리 중이라는 뜻입니다. 두 경우 모두 클라이언트는 새 명령으로 재제출하지 말고 완료 스트림에서 원래 명령의 결과를 확인해야 합니다.
A.1.8 repair 기록 방식: repair_counter
맥락. 한 participant의 ACS가 손상되었을 때 동기화기 전체를 멈추지 않고 그 participant만 고칠 수 있어야 합니다. 고친 이력도 남아야 합니다.
메커니즘. repair 명령은 기존 행을 지우거나 덮어쓰지 않고 par_active_contracts에 행을 추가합니다. 기본 키에 repair_counter가 들어 있는 이유가 이것입니다. 일반 프로토콜로 생긴 변경은 최소 repair 카운터로 기록됩니다. repair는 현재 clean 레코드 시각에, 같은 타임스탬프 안에서 0, 1, 2… 순서의 카운터로 기록됩니다. 그래서 한 시각에 여러 번의 repair가 있어도 순서가 보존되고, 프로토콜 변경과 repair 변경을 구분해 조회할 수 있습니다. operation 열거형의 'purge'와 'add'는 repair로 생긴 비활성화와 활성화를 나타냅니다.
런북. 절차와 명령 서명은 A.4.9에 있습니다.
A.1.9 노드별 관측 데이터와 위조 거부 지점
맥락. 보안 검토와 감사에서 반복되는 질문은 두 가지입니다. 각 노드가 무엇을 볼 수 있는가, 그리고 잘못된 요청을 누가 어떤 검사로 거부하는가. 아래 두 표는 본편 제2부의 프로토콜 설명을 운영자 관점에서 다시 정리한 것입니다.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
| 컴포넌트 | 관측하는 데이터 | 관측하지 못하는 데이터 | 하는 일 |
|---|---|---|---|
| 순서자 | 송신자, 수신자 목록, 메시지 크기, 자신이 붙인 타임스탬프, 암호화된 봉투 | 뷰 평문(복호화 키가 없음) | 전체 순서 결정, 타임스탬프 부여, 수신자별 전달, 트래픽 계량 |
| 중재자 | 루트 해시, 뷰별 확인 당사자와 정족수, 각 participant의 확인 응답과 서명 | 계약 인자, 금액 등 뷰 본문(블라인드 처리됨) | 확인 응답 집계, 판정(승인·거부·타임아웃) 발행 |
| participant | 자신이 호스팅하는 당사자가 informee인 뷰의 평문 | 같은 트랜잭션의 다른 뷰(블라인드된 해시만 받음) | 뷰 복호화, 검증, 확인 응답, 판정에 따른 커밋 |
| 동기화기 운영 주체(토폴로지 소유자) | 토폴로지 트랜잭션(키, 당사자 호스팅, 패키지 vetting, 파라미터) | 거래 내용 | 동적 파라미터 변경, 멤버 관리, 업그레이드 공지 |
메커니즘. 한 요청의 시간선은 두 기한으로 정해집니다. participant는 응답 기한까지 확인 응답을 보내야 하고, 중재자는 판정 시각까지 판정을 내야 합니다.
\(\Delta_{\text{conf}}\)는 confirmationResponseTimeout(기본 30초), \(\Delta_{\text{med}}\)는 mediatorReactionTimeout(기본 30초)입니다.
기본값에서 판정 시각은 시퀀싱 시각 + 60초입니다. 응답 기한 뒤에 도착한 확인 응답은 집계에 들어가지 않습니다.
participant의 검증은 열 개 안팎의 항목으로 이루어집니다. 계약 일관성, 인증, 권한, 모델 적합성, 내부 일관성, 외부 호출, 활성 여부, 시간, 재생(replay), 루트 해시와 수신자 검사입니다. 아래 표는 대표적인 잘못된 요청과 그것을 거부하는 검사를 짝지은 것입니다.
| 잘못된 요청 | 거부하는 주체와 검사 | 관측되는 결과 |
|---|---|---|
| 제출자가 수신자마다 서로 다른 뷰를 보냄(equivocation) | participant. 모든 수신자가 받는 루트 해시 메시지와 자신이 받은 뷰의 루트 해시를 대조 | LOCAL_VERDICT_BAD_ROOT_HASH_MESSAGES |
| 뷰 내용이 Daml 모델을 재실행한 결과와 다름 | participant. 모델 적합성 검사 | LOCAL_VERDICT_FAILED_MODEL_CONFORMANCE_CHECK |
| 이미 소비된 계약을 다시 소비 | participant. 활성 검사 | LOCAL_VERDICT_INACTIVE_CONTRACTS |
| 다른 미결 요청이 잠근 계약을 소비 | participant. 충돌 감지(A.1.2) | LOCAL_VERDICT_LOCKED_CONTRACTS |
| 원장 시각이 시퀀싱 시각과 허용 범위 이상 차이 남 | participant. 시간 검사(ledgerTimeRecordTimeTolerance, 기본 60초) |
LOCAL_VERDICT_LEDGER_TIME_OUT_OF_BOUND |
| 준비 시각(preparation time)이 시퀀싱 시각과 허용 범위 이상 차이 남 | participant. 시간 검사(준비 시각 허용 오차, 기본 24시간) | LOCAL_VERDICT_PREPARATION_TIME_OUT_OF_BOUND |
| 확인자가 응답 기한까지 응답하지 않음 | 중재자. 판정 시각에 타임아웃 판정 | MEDIATOR_SAYS_TX_TIMED_OUT |
| 확인 권한이 없는 participant가 응답을 보냄 | 중재자. 확인할 수 없는 participant의 응답은 집계에서 버림 | 판정에 영향 없음 |
중재자의 판정은 두 단계로 계산됩니다. 당사자 단위로는, 그 당사자를 호스팅하면서 확인 권한이 있는 participant 중 당사자의 확인 임계치 이상이 승인하면 그 당사자가 승인한 것으로 봅니다. 뷰 단위로는, 승인한 당사자의 가중치만큼 정족수 임계치를 줄여 나갑니다. 모든 뷰의 모든 정족수가 0에 도달하면 승인이고, 어느 정족수든 더는 채울 수 없게 되면 바로 거부입니다.
순서자와 중재자 운영자가 공모하면 무엇을 할 수 있고 무엇을 할 수 없습니까?
두 노드가 가진 정보를 합쳐도 위 표의 "관측하는 데이터" 범위를 넘지 않습니다. 뷰는 수신 participant의 공개키로 암호화되어 있고, 두 노드에는 복호화 키가 없습니다. 다만 누가 누구와 언제 얼마나 큰 메시지를 주고받는지는 알 수 있습니다. 이 메타데이터까지 숨겨야 하면 동기화기 운영 주체를 별도로 두거나 자체 동기화기를 운영해야 합니다.
두 노드는 participant의 서명을 만들 수 없고, 뷰 평문이 없으므로 거래 내용을 지어낼 수도 없습니다. 반면 메시지를 지연시키거나 전달하지 않는 것(가용성 공격)은 가능하고, 판정의 정확성은 중재자에 대한 신뢰 가정에 속합니다. 이 의존을 줄이는 수단이 BFT 순서자 그룹(A.2.5)과 임계치를 둔 중재자 그룹입니다.
A.2 용량·성능 산정
이 묶음은 크기를 정해야 하는 설정을 다룹니다. 각 절은 기본값을 먼저 밝히고, 그 값을 바꿀 근거가 되는 공식과 전제를 제시합니다. 공식은 출발점을 정하기 위한 설명용 모형입니다. 최종값은 대상 워크로드로 부하 시험을 해서 정하십시오.
A.2.1 DB 연결 풀과 스레드
맥락. participant의 DB 연결 수는 PostgreSQL의 max_connections, 연결 풀러, HA 구성과 함께 정해야 합니다. 연결이 모자라면 질의가 큐에서 대기하다가 DB_STORAGE_DEGRADATION이 보고됩니다. 연결이 지나치게 많으면 PostgreSQL 쪽에서 컨텍스트 전환과 메모리 사용이 늘어납니다.
메커니즘. 최대 연결 수 \(X\)의 기본값은 노드가 감지한 스레드 수입니다. 복제(HA) 구성의 participant는 \(X\)를 용도별 풀로 나눕니다. 복제하지 않는 노드는 하나의 통합 풀을 씁니다.
인덱서는 별도 풀을 쓰므로, participant 하나가 PostgreSQL에 여는 연결의 상한은 다음과 같습니다
예시 수치. \(X = 32\)이면 Ledger API 풀 16, 읽기 풀 8, 쓰기 풀 7, 메인 연결 1로 합계 32입니다. 인덱서 기본 풀 22를 더하면 participant 하나에 54개입니다.
active와 passive 복제본은 같은 DB에 연결하므로, PostgreSQL의 max_connections는 두 복제본이 열 수 있는 연결의 합에 관리용 여유분을 더해 잡으십시오.
설정. 최대 연결 수는 storage.parameters.max-connections로 지정합니다. 지정하지 않으면 감지된 스레드 수가 쓰이는데, 컨테이너의 CPU 제한이 JVM에 어떻게 보이는지에 따라 값이 달라지므로 프로덕션에서는 명시하는 편이 안전합니다.
canton.participants.participant1 {
  storage {
    type = postgres
    config {
      dataSourceClass = "org.postgresql.ds.PGSimpleDataSource"
      properties {
        serverName = "pg-primary.internal"
        portNumber = 5432
        databaseName = "canton_participant"
        user = "canton_svc"
        password = ${?POSTGRES_PASSWORD}
      }
    }
    parameters {
      max-connections = 32   # 생략하면 감지된 스레드 수
    }
  }
}
실패 양상. DB_STORAGE_DEGRADATION은 저장소 작업이 실패하거나 큐가 넘칠 때 보고됩니다. DB_CONNECTION_LOST는 연결 자체가 끊겼다는 뜻입니다. 두 오류가 부하 피크와 겹치면 풀 크기보다 PostgreSQL의 I/O 지연을 먼저 의심하십시오. 풀을 키우면 대기 위치가 Canton에서 PostgreSQL로 옮겨갈 뿐입니다.
A.2.2 Ledger API 팬아웃 버퍼와 캐시
맥락. Ledger API의 업데이트 스트림을 여러 클라이언트가 구독합니다. 최신 지점을 따라가는 구독자가 매번 DB를 읽으면 쓰기 부하와 경쟁합니다.
메커니즘. 인덱스 서비스는 최근 트랜잭션을 메모리 버퍼에 유지하고, 버퍼 범위 안의 지점을 읽는 스트림에는 메모리에서 바로 전달합니다. 이 버퍼가 덜어 주는 것은 "최신 지점 근처의 업데이트 스트림"뿐입니다. 다음 요청은 버퍼와 무관하게 DB를 읽습니다.
- 버퍼 범위보다 오래된 오프셋에서 시작하는 스트림
- ACS 조회
- 완료(completion) 스트림
- 이벤트·계약 단건 조회
설정. 버퍼 크기는 ledger-api.index-service.max-transactions-in-memory-fan-out-buffer-size이고 기본값은 1100입니다. 기본값보다 작게 설정하면 메모리에서 처리되는 범위가 줄어듭니다. 계약 상태 캐시(max-contract-state-cache-size)와 계약 키 상태 캐시(max-contract-key-state-cache-size)의 기본값은 각각 10,000입니다.
설명용 모형. \(B\)는 버퍼 크기(트랜잭션 수), \(\lambda_{\text{peak}}\)는 participant가 초당 확정하는 트랜잭션 수의 피크, \(T_{\text{window}}\)는 구독자가 뒤처져도 메모리에서 처리되는 시간 폭입니다.
예시 수치로, 기본값 \(B = 1100\)에서 \(\lambda_{\text{peak}} = 200\)/s이면 약 5.5초, 50/s이면 약 22초입니다.
구독자가 이보다 오래 뒤처지면 그 스트림은 DB 읽기로 돌아갑니다. 버퍼를 키우면 힙 사용량이 트랜잭션 평균 크기에 비례해 늘어나므로, 힙 여유와 함께 정하십시오.
실패 양상. 느린 구독자가 많으면 버퍼가 있어도 DB 읽기 부하가 줄지 않습니다. 이 경우 버퍼를 키우기 전에 구독자 쪽 처리 속도와 재접속 빈도를 확인하십시오.
A.2.3 ack 주기와 순서자 보존량
맥락. 순서자는 멤버가 아직 읽지 않았을 수 있는 이벤트를 지우지 않습니다. 멤버가 "여기까지 처리했다"고 알리는 것이 ack입니다. ack가 늦거나 멈추면 순서자의 디스크 사용량이 늘어납니다.
메커니즘. 순서자의 안전 프루닝 지점은 활성 멤버 각각의 마지막 ack 시각(ack가 한 번도 없으면 등록 시각) 중 가장 이른 값입니다.
이 지점 이후의 이벤트가 보존되므로, 순서자 보존량은 다음 모형으로 가늠합니다
이 식은 순서자 프루닝에만 해당합니다. participant 프루닝은 다른 조건(ACS commitment, 미결 요청, 최대 중복 제거 기간)으로 따로 제한됩니다. 두 경계를 하나의 최솟값으로 합쳐 생각하면 안 됩니다. 순서자에서 멤버를 비활성화해도 participant 쪽 경계는 움직이지 않습니다(A.4.3, A.4.4).
설정. participant가 ack를 보내는 주기는 sequencer-client.acknowledgement-interval이고 기본값은 1분입니다. 주기를 늘리면 ack 메시지는 줄지만 순서자의 안전 프루닝 지점이 그만큼 뒤처집니다. 유휴 동기화기에서는 시간 추적기의 minObservationDuration(A.1.6)이 ack할 이벤트를 만들어 줍니다.
런북. 멤버별 ack 상태는 sequencer.pruning.status()로 봅니다. 결과에는 현재 하한(lowerBound), 순서자의 현재 시각(now), 멤버 목록(members)이 있고, 멤버마다 등록 시각, 마지막 ack, 활성 여부가 나옵니다. 정지 상황의 처리는 A.4.3에 있습니다.
A.2.4 Admin API·Ledger API 한도
맥락. 무거운 관리 호출(ACS 내보내기, 토폴로지 스냅샷)이나 폭주하는 클라이언트가 실시간 제출 경로의 자원을 잠식하면 안 됩니다. 반대로 한도가 너무 낮으면 정상적인 복구 작업이 실패합니다.
설정. 한도는 세 종류입니다. 메시지 크기, 동시 스트림 수, 힙 사용률입니다.
| 한도 | 설정 키 | 기본값 | 비고 |
|---|---|---|---|
| gRPC 수신 메시지 크기 | max-inbound-message-size(API별) |
10MB | 스트리밍이 아닌 단일 메시지로 큰 페이로드를 받는 경우에만 올림 |
| Admin API 동시 스트림 수 | admin-api.limits.active(메서드별 맵) |
ACS 내보내기, 토폴로지 스냅샷 등 스트리밍 엔드포인트마다 10 | 키는 패키지 접두사를 포함한 gRPC 전체 메서드 이름 |
| Ledger API 힙 사용률 상한 | ledger-api.rate-limit.max-used-heap-space-percentage |
100(사실상 꺼짐) | 낮추면 힙 사용률이 이 값을 넘을 때 새 요청을 거부. 남은 힙의 절대량으로 거는 min-free-heap-space-bytes(기본 0)도 있음 |
canton.participants.participant1 {
  admin-api {
    address = "127.0.0.1"        # A.3.4 참조
    port = 5002
    limits.active {
      # 키는 "<패키지>.<서비스>/<메서드>" 형식의 전체 메서드 이름.
      # 아래 "…" 자리에 실제 패키지 접두사를 넣는다(서비스 정의 파일에서 확인).
      "….admin.participant.v30.ParticipantRepairService/ExportAcs" = 4
    }
  }
  ledger-api {
    port = 5001
    rate-limit {
      max-used-heap-space-percentage = 85
    }
  }
}
실패 양상. 힙 상한을 넘으면 HEAP_MEMORY_OVER_LIMIT으로 거부됩니다. participant가 과부하로 제출을 받지 못할 때는 PARTICIPANT_BACKPRESSURE가 납니다. 두 오류는 재시도 가능한 과부하 신호이므로, 클라이언트는 지수 백오프로 재시도해야 합니다. 메서드 이름을 접두사 없이 적으면 한도가 적용되지 않습니다. 설정 후에는 한도를 넘는 동시 호출을 실제로 걸어 거부되는지 확인하십시오.
A.2.5 BFT 순서자 수
맥락. 여러 기관이 동기화기를 공동 운영할 때, 일부 순서자가 멈추거나 악의적으로 동작해도 순서화가 계속되고 갈라지지 않아야 합니다. 노드 수는 허용할 결함 수에서 역산합니다.
메커니즘. 순서자 \(N\)대 중 허용 가능한 비잔틴 결함 수는 \(f = \lfloor (N-1)/3 \rfloor\)입니다. 결정에는 강한 정족수가 필요하고, 일부 확인에는 약한 정족수(\(f+1\))를 씁니다.
\(N = 3f + 1\)일 때 \(Q_{\text{strong}} = 2f + 1\)이고, 두 강한 정족수는 반드시 정직한 노드를 하나 이상 공유합니다
| \(N\) | \(f\) | 강한 정족수 | 약한 정족수 | 비고 |
|---|---|---|---|---|
| 3 | 0 | 3 | 1 | 한 대만 멈춰도 진행 불가. 결함 허용 없음 |
| 4 | 1 | 3 | 2 | 비잔틴 결함 1을 허용하는 최소 구성 |
| 5 | 1 | 4 | 2 | 4대 구성보다 허용 결함 수가 늘지 않음 |
| 7 | 2 | 5 | 3 | |
| 10 | 3 | 7 | 4 | |
| 13 | 4 | 9 | 5 |
한 에포크(기본 길이 16블록) 안에서 블록 \(s\)의 리더는 leaders[(s − epochStart) mod K]로 정해집니다. \(K\)는 그 에포크의 리더 수입니다. 리더 하나가 느려지면 그 리더 차례의 블록이 늦어지고, 출력은 순서대로 나가야 하므로(A.1.5) 뒤 블록도 함께 기다립니다.
산정. 허용할 결함 수 \(f\)를 먼저 정하고 \(N = 3f + 1\)로 잡습니다. \(3f + 2\)나 \(3f + 3\)대는 정족수만 커지고 허용 결함 수는 그대로입니다. 운영 주체, 클라우드 계정, 가용 영역이 겹치면 한 번의 사고로 여러 대가 함께 멈추므로, 결함 수는 대수가 아니라 독립된 장애 영역 수로 세십시오.
실패 양상. 응답하는 순서자가 강한 정족수에 못 미치면 순서화가 멈춥니다. 이때 participant의 제출은 판정 시각까지 결과를 받지 못하고 타임아웃됩니다. 정족수가 회복되면 순서화가 재개됩니다. 피어 연결 상태는 메트릭 daml.sequencer.bftordering.p2p.endpoint-status(레이블 p2p-endpoint, Prometheus에서는 p2p_endpoint)로 봅니다.
런북. 로컬에서 정족수 동작을 직접 확인하는 실습은 A.6.6에 있습니다.
A.2.6 순서자 트래픽 예산
맥락. 트래픽 제어가 켜진 동기화기에서는 멤버가 보내는 메시지마다 비용이 계산되고, 잔액이 모자라면 제출이 거부됩니다. 토큰이 없는 동기화기에서도 같은 장치로 멤버별 사용량을 제한하고 계량합니다(A.6.3).
메커니즘. 모든 멤버에는 시간에 따라 회복되는 기본 트래픽이 있고, 그 위에 구매(또는 할당)한 추가 트래픽이 있습니다. 기본 트래픽을 먼저 쓰고, 다 쓰면 추가 트래픽을 씁니다.
봉투 하나의 비용은 크기에 수신자 수에 비례하는 읽기 비용을 더한 값입니다
\(b_e\)는 봉투의 바이트 수, \(n_e\)는 수신자 수, \(\rho\)는 readVsWriteScalingFactor(기본 200), \(c_{\text{base}}\)는 baseEventCost(기본 0)입니다.
예시 수치로, 기본값 200 KiB / 10분이면 기본 트래픽 회복 속도는 약 341 B/s입니다. 2,000바이트 봉투를 수신자 3명에게 보내면 비용은 \(2{,}000 + 2{,}000 \times 3 \times 200 / 10{,}000 = 2{,}120\)바이트입니다.
산정. participant가 필요한 추가 트래픽은 "초당 제출 수 × 제출당 평균 비용 − 기본 회복 속도"에 확인 응답과 ack, time proof 요청이 쓰는 양을 더해 가늠합니다. 뷰 수와 수신자 수가 많은 트랜잭션일수록 비용이 커지므로, 평균 비용은 실제 워크로드에서 측정하십시오.
실패 양상. 잔액이 모자라면 SEQUENCER_NOT_ENOUGH_TRAFFIC_CREDIT으로 거부됩니다. 제출 시점에 계산한 비용이 그 사이 바뀐 파라미터와 맞지 않으면 OUTDATED_TRAFFIC_COST가 납니다.
런북. participant 쪽에서는 participant.traffic_control.traffic_state로 자신의 상태를 보고, 순서자 쪽에서는 sequencer.traffic_control.traffic_state_of_members로 멤버별 상태를 봅니다.
A.3 보안·키 관리
이 묶음은 키를 어디에 두고 어떻게 쓰는지, API를 어디까지 노출하는지를 다룹니다. 보안 설정은 대개 성능과 맞바꾸는 관계에 있으므로, 각 절에서 무엇을 얻고 무엇을 내주는지를 함께 적습니다.
A.3.1 KMS 연동과 지원 키 종류
맥락. 노드의 장기 개인키를 프로세스 메모리나 디스크에 두지 않으려면 외부 KMS(클라우드 KMS, HSM 기반 서비스)에 보관합니다. 이 경우 서명과 복호화가 원격 호출이 됩니다.
설정. crypto.provider = kms로 두고 crypto.kms 블록에 제공자별 항목을 적습니다. AWS는 region, multi-region-key, audit-logging 등을 받고, GCP는 location-id, project-id, key-ring-id 등을 받습니다. 개별 키를 설정 파일에서 식별자로 지정하는 필드는 없습니다. 키는 노드가 KMS에 생성하거나, 미리 만든 키를 콘솔의 keys.secret.register_kms_signing_key, register_kms_encryption_key로 등록합니다.
canton.participants.participant1.crypto {
  provider = kms
  kms {
    type = aws
    region = "eu-west-1"
    multi-region-key = false
    audit-logging = true      # KMS 호출을 Canton 로그에 남김
  }
}
실패 양상. Canton의 AWS KMS 연동은 Ed25519(Curve25519) 서명 키를 지원하지 않는 키 종류로 거부합니다. AWS KMS에 두는 서명 키는 EC P-256이나 P-384 사양으로 만드십시오. KMS로 전환할 때는 노드가 쓰는 서명 키 사양이 그 KMS가 지원하는 사양인지, 그리고 연결할 동기화기가 그 사양을 허용하는지 확인해야 합니다.
산정. KMS 비용은 세 항목으로 나눠 계산합니다. 키당 고정 요금, 호출당 요금, 초당 요청 한도입니다. 서명과 비대칭 복호화에는 대칭 키 연산과 다른 단가가 적용되는 것이 보통입니다. 단가와 한도는 제공자, 리전, 키 종류에 따라 다르고 자주 바뀌므로 이 책에 싣지 않습니다. 사용하는 제공자의 요금표와 쿼터 문서에서 비대칭 연산 항목을 확인하십시오. 호출 횟수를 가늠하는 식은 다음 절에 있습니다.
A.3.2 KMS 호출 줄이기: 세션 서명 키와 세션 암호화 키 캐시
맥락. 외부 KMS에 장기 키를 두면 서명과 복호화마다 원격 호출이 생깁니다. 호출마다 네트워크 왕복 지연이 더해지고, 호출 수는 제공자의 초당 한도와 요금에 걸립니다. Canton은 두 가지 장치로 이 호출 수를 줄입니다.
메커니즘 1: 세션 서명 키. 노드가 메모리에 단명 서명 키를 만들고, KMS의 장기 키로는 "이 세션 키가 이 기간 동안 이 동기화기에서 유효하다"는 위임에만 서명합니다. 위임이 서명하는 대상은 세션 키 지문, 유효 기간, 동기화기 ID입니다. 이후 프로토콜 메시지는 세션 키로 서명하고, 검증자는 위임과 서명을 함께 확인합니다. 이 기능은 기본적으로 꺼져 있습니다.
설정(crypto.session-signing-keys) | 기본값 | 의미 |
|---|---|---|
enabled | false | 세션 서명 키 사용 여부 |
key-validity-duration | 5분 | 세션 키 하나의 유효 기간 |
tolerance-shift-duration | 2분 | 조금씩 다른 타임스탬프를 한 유효 구간으로 묶기 위해 구간을 앞으로 당기는 폭 |
cut-off-duration | 1분 | 검증 시점을 미리 알 수 없을 때 허용하는 시계 차이. 유효 구간의 양 끝에서 이만큼은 쓰지 않음 |
key-eviction-period | 10분 | 세션 개인키를 메모리에 유지하는 시간 |
메커니즘 2: 세션 암호화 키 캐시. 뷰는 대칭 세션 키로 암호화하고, 그 세션 키를 수신자의 공개키로 다시 암호화합니다. 캐시는 송신 쪽에서 같은 수신자 집합에 대한 세션 키를 재사용하게 하고, 수신 쪽에서는 이미 복호화한 세션 키를 기억하게 합니다. 수신 쪽 캐시가 적중하면 그 메시지에 대해서는 비대칭 복호화(KMS 호출)를 건너뜁니다.
설정(parameters.caching.session-encryption-key-cache) | 기본값 |
|---|---|
enabled | true |
sender-cache / receiver-cache의 maximum-size | 10,000 |
sender-cache / receiver-cache의 expire-after-timeout | 10초 |
설명용 모형, 예시 수치. \(\lambda_{\text{sign}}\)은 노드가 초당 만드는 서명 수입니다.
- 초당 50회이면 장기 키로 직접 서명할 때 하루 4,320,000회를 호출합니다.
- 세션 서명 키를 켜고 유효 기간을 기본값 300초로 두면 위임 서명은 동기화기당 하루 288회 안팎입니다.
cut-off와 타임스탬프 분포에 따라 실제 횟수는 이보다 많아질 수 있습니다. 이 식은 호출 횟수만 다룹니다. 금액은 A.3.1의 방법으로 제공자 요금표에서 계산하십시오.
상충. 두 장치 모두 "KMS 밖에 있는 키 재료가 유효한 시간"을 늘려 호출 수를 줄입니다. 세션 서명 키의 유효 기간을 늘리면, 노드 메모리가 탈취되었을 때 공격자가 그 키로 서명할 수 있는 시간이 늘어납니다. 세션 암호화 키 캐시의 만료 시간을 늘리면(예를 들어 10초에서 1시간으로), 한 세션 키로 보호되는 메시지 범위와 그 키가 메모리에 머무는 시간이 함께 늘어납니다. 기본값이 짧은 것은 이 노출 범위를 좁히기 위해서입니다. 값을 늘릴 때는 줄어드는 호출 수와 늘어나는 노출 범위를 함께 기록해 보안 검토를 받으십시오.
실패 양상. 세션 서명 키를 만들지 못해 장기 키 서명으로 되돌아간 횟수는 KMS 메트릭의 세션 서명 키 fallback 카운터로 볼 수 있습니다. 이 값이 늘면 호출 수 절감 효과가 사라지고 있다는 뜻입니다. cut-off는 ledgerTimeRecordTimeTolerance보다 짧으면 안 되고, eviction 기간은 유효 기간과 participant 응답 기한보다 길어야 합니다. 이 관계가 깨지면 서명 검증 실패나 불필요한 키 재생성이 늘어납니다.
A.3.3 노드 키 교체
맥락. 보안 정책은 서명 키와 암호화 키의 주기적 교체를 요구합니다. 교체 중에도 노드는 계속 트랜잭션을 처리해야 합니다.
메커니즘. 노드의 운영 키(프로토콜 서명 키, 암호화 키)는 네임스페이스 키와 분리되어 있습니다. 교체는 토폴로지 트랜잭션으로 이루어집니다. 새 키를 만들고, 새 키를 노드의 키 매핑에 추가하고, 이전 키를 제거합니다. 다른 노드는 토폴로지 상태에서 새 키를 알게 됩니다. 네임스페이스 키는 이 과정에서 바뀌지 않으며, 노드의 식별자도 유지됩니다.
// 노드의 서명 키와 암호화 키를 모두 새 키로 교체한다(네임스페이스 키는 유지)
participant1.keys.secret.rotate_node_keys()

// 교체 뒤 토폴로지에 등록된 키를 확인한다
participant1.topology.owner_to_key_mappings.list()

// 키 하나만 교체하려면 rotate_node_key,
// KMS에 미리 만든 키로 교체하려면 rotate_kms_node_key를 쓴다(인자는 콘솔 help 참조)
실패 양상. 교체 직후 일부 상대가 아직 이전 토폴로지 스냅샷을 쓰는 구간에는 이전 키로 암호화된 메시지가 도착할 수 있습니다. 이전 개인키를 곧바로 삭제하지 말고, 미결 요청의 판정 시각이 지난 뒤 정리하십시오. KMS를 쓰는 경우 이전 키의 삭제 예약 기간도 이 시간보다 길어야 합니다.
A.3.4 Admin API 노출 범위와 Ledger API 토큰 검증
맥락. Admin API는 키 생성, 토폴로지 변경, repair를 실행할 수 있습니다. Ledger API는 당사자를 대신해 명령을 제출할 수 있습니다. 두 API의 노출 범위와 인증은 노드 보안의 기본입니다.
설정. Admin API는 루프백이나 관리 전용 네트워크에만 바인딩하고, 원격 운영이 필요하면 상호 TLS와 접근 통제가 있는 경로(배스천, 관리망)를 거치게 합니다. Ledger API는 JWT 검증을 켭니다. JWKS 방식은 인증 서버의 공개키 집합 URL에서 키를 받아 토큰 서명을 검증합니다.
canton.participants.participant1.ledger-api {
  address = "10.20.30.15"
  port = 5001
  auth-services = [{
    type = jwt-jwks
    url = "https://sso.example.internal/oauth2/v1/keys"
    target-audience = "https://ledger.example.internal"
    # 또는 target-scope = "daml_ledger_api"
  }]
}
target-audience를 지정하면 토큰의 audience가 그 값과 일치해야 합니다. 지정하지 않으면 같은 인증 서버가 다른 서비스용으로 발급한 토큰도 서명 검증을 통과합니다. audience 기반과 scope 기반은 토큰 형식이 다르므로, 인증 서버가 발급하는 토큰 형식에 맞춰 하나를 고르십시오. 토큰 수명은 짧게 두고, 장기 실행 서비스는 토큰을 갱신하도록 만듭니다.
실패 양상. 토큰 검증 실패는 gRPC UNAUTHENTICATED, 권한 부족은 PERMISSION_DENIED로 나타납니다. JWKS URL에 닿지 못하면 키를 갱신하지 못해 새 서명 키로 발급된 토큰이 거부됩니다. 인증 서버의 키 교체 주기와 JWKS 캐시 설정을 맞춰 두십시오.
A.3.5 외부 서명 당사자와 지갑 연동
맥락. 당사자의 서명 키를 participant가 아니라 당사자 쪽(지갑, 수탁 서비스, HSM)에 두는 구성이 있습니다. 이 경우 participant 운영자는 그 당사자를 대신해 트랜잭션에 서명할 수 없습니다.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
메커니즘. 외부 서명은 두 단계 제출로 이루어집니다. 클라이언트가 participant에 명령을 보내 트랜잭션을 준비시키면, participant는 준비된 트랜잭션과 그 해시를 돌려줍니다. 클라이언트는 트랜잭션 내용을 직접 확인하고 해시에 서명한 뒤, 서명과 함께 실행을 요청합니다. 준비 시각과 시퀀싱 시각의 차이는 준비 시각 허용 오차(기본 24시간) 안에 있어야 하고, 벗어나면 LOCAL_VERDICT_PREPARATION_TIME_OUT_OF_BOUND로 거부됩니다. 사람이 서명 장치로 승인하는 데 걸리는 시간을 감안해 허용 오차가 원장 시각(60초)보다 훨씬 깁니다.
서명 키를 어디에 두고 사용자를 어떻게 인증하는지는 지갑 구현이 정합니다. 기업 SSO로 인증하고 서비스 제공자가 키를 수탁하는 구성도 있고, 사용자 기기의 보안 요소나 HSM에 키를 두는 구성도 있습니다. Canton 프로토콜은 서명 방식과 해시 규칙을 정할 뿐, 인증 수단을 규정하지 않습니다. 특정 CIP가 특정 인증 수단을 표준으로 정했는지는 해당 CIP 원문에서 확인하십시오. 이 책은 그 내용을 검증하지 못했으므로 단정하지 않습니다.
운영 관점. Canton의 자산은 계좌 잔고가 아니라 보유 계약 여러 개로 존재합니다. 지갑 백엔드는 이를 합산해 하나의 잔고로 보여 주고, 계약 수가 지나치게 늘면 병합합니다. Splice 지갑에서는 사용자가 지갑 서비스에 자동화를 위임하는 계약(WalletAppInstall)과, 수신자가 미리 수취에 동의해 두는 계약(TransferPreapproval)이 이 역할을 합니다. 사전 승인의 갱신 수수료는 기본 기간(기본 90일)을 넘는 연장 일수에 일당 0.00274 USD를 곱해 당시 amulet 가격으로 환산합니다. 운영자가 확인할 것은 두 가지입니다. 자동화가 어떤 당사자 권한으로 실행되는지, 그리고 그 권한이 어떤 계약으로 위임되었는지입니다.
A.4 운영 런북
이 묶음은 장애 상황별 절차입니다. 각 런북은 증상, 원인, 하지 말아야 할 조치, 확인 순서로 구성됩니다. 콘솔 명령은 기준 버전의 관리 콘솔에 있는 이름과 인자입니다. 예제의 participant1, sequencer1, "mysync"는 여러분 환경의 노드 참조와 동기화기 별칭으로 바꿔 읽으십시오. 복구 목표 시간은 데이터 크기와 인프라에 따라 달라지므로 적지 않았습니다. 여러분 환경에서 훈련으로 측정해 런북에 기록해 두십시오.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
A.4.1 런북: DB 디스크가 가득 찼을 때
맥락. PostgreSQL 데이터 볼륨이나 WAL 볼륨이 가득 차면 쓰기가 실패합니다. Canton 노드는 DB_STORAGE_DEGRADATION을 보고하고, 그 노드가 처리해야 하는 요청은 진행되지 않습니다.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
영향 범위. 한 participant의 DB가 멈춰도 동기화기와 다른 participant는 계속 동작합니다. 영향을 받는 것은 그 participant가 확인자인 트랜잭션입니다. 이 트랜잭션들은 확인 응답을 받지 못해 판정 시각에 MEDIATOR_SAYS_TX_TIMED_OUT으로 끝나고, 그때까지 관련 계약은 상대 participant에서 잠긴 상태로 남습니다(A.1.2). 무기한 대기는 생기지 않습니다. 순서자의 DB가 멈춘 경우는 A.5.3을 보십시오.
하지 말아야 할 조치.
pg_wal디렉터리의 파일을 수동으로 지우지 마십시오. 아직 체크포인트되지 않은 WAL을 지우면 PostgreSQL이 복구 불가능한 상태가 될 수 있습니다.- Canton 테이블을
TRUNCATE하거나 행을 직접 지우지 마십시오. ACS commitment가 어긋나고 복구 지점이 사라집니다. - 공간이 없는 상태에서 프루닝부터 실행하지 마십시오.
DELETE도 WAL을 쓰므로 공간이 더 필요합니다.
런북.
- 증거 보존. 노드가 응답하면
health.dump()를 먼저 받아 둡니다(A.5.1). - 공간 확보. 볼륨을 온라인으로 확장합니다. 확장할 수 없으면 PostgreSQL 바깥의 파일(오래된 로그, 임시 파일)을 정리합니다.
- WAL이 쌓인 원인 확인. 끊어진 복제 슬롯이 WAL 삭제를 막고 있는지 봅니다(아래 SQL). 아카이빙 실패도 같은 증상을 만듭니다.
- 노드 상태 확인. PostgreSQL이 쓰기를 재개하면 Canton 노드는 재시도로 복구됩니다. 복구되지 않으면 노드를 재시작합니다. participant는 마지막 clean 지점부터 이벤트를 다시 처리합니다.
- 프루닝. 여유 공간이 생긴 뒤 A.4.2와 A.4.4의 절차로 프루닝합니다.
-- 복제 슬롯이 붙잡고 있는 WAL 양
SELECT slot_name, active,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained_wal
FROM pg_replication_slots;

-- 큰 테이블 순서로 전체 크기, 힙 크기, 죽은 튜플 비율
SELECT relname,
       pg_size_pretty(pg_total_relation_size(relid)) AS total_size,
       pg_size_pretty(pg_relation_size(relid))       AS heap_size,
       n_live_tup, n_dead_tup,
       round(100.0 * n_dead_tup / GREATEST(n_live_tup + n_dead_tup, 1), 2) AS dead_pct,
       last_autovacuum
FROM pg_stat_user_tables
ORDER BY pg_total_relation_size(relid) DESC
LIMIT 10;
재발 방지. 디스크 사용률 경보를 두 단계(예: 70%, 85%)로 두고, PostgreSQL의 max_slot_wal_keep_size로 복제 슬롯이 붙잡을 수 있는 WAL 양에 상한을 둡니다. 프루닝을 일정으로 자동화하고(A.4.2), 순서자 쪽은 A.2.3의 모형으로 증가 속도를 추적합니다.
A.4.2 런북: 프루닝 후에도 디스크 사용량이 줄지 않을 때
맥락. 프루닝으로 많은 행을 지웠는데 운영체제에서 본 디스크 사용량은 그대로입니다.
메커니즘. PostgreSQL의 DELETE는 파일을 줄이지 않습니다. 행에 삭제 표시만 하고, 이후 VACUUM이 그 공간을 같은 테이블이 다시 쓸 수 있게 표시합니다. 운영체제에 공간이 반환되는 것은 테이블 끝의 빈 페이지가 잘려 나갈 때뿐입니다. 따라서 프루닝 직후에 기대할 수 있는 것은 "더 늘지 않는다"이고, "줄어든다"가 아닙니다.
설정. 큰 테이블에서는 autovacuum의 기본 발동 조건(autovacuum_vacuum_scale_factor = 0.2, 전체 행의 20%가 죽은 뒤)이 너무 늦습니다. 변경이 많은 Canton 테이블에는 테이블 단위로 더 낮은 값을 줍니다. 아래 수치는 출발점이며, 죽은 튜플 비율을 관찰하면서 조정하십시오.
ALTER TABLE par_active_contracts SET (
  autovacuum_vacuum_scale_factor = 0.02,
  autovacuum_vacuum_cost_limit   = 2000
);
ALTER TABLE common_sequenced_events SET (
  autovacuum_vacuum_scale_factor = 0.02,
  autovacuum_vacuum_cost_limit   = 2000
);
하지 말아야 할 조치. 서비스 중에 VACUUM FULL을 실행하지 마십시오. 테이블 전체에 배타 잠금을 걸고 테이블을 다시 쓰므로, 그동안 노드의 모든 읽기와 쓰기가 멈춥니다. 공간을 운영체제에 돌려줘야 하면 유지보수 시간대에 실행하거나, 온라인 재구성 도구(pg_repack 등)를 검증한 뒤 쓰십시오.
런북. participant 프루닝은 안전 오프셋을 먼저 구한 뒤 그 지점까지 지웁니다.
// 72시간 이전 시점을 기준으로, 그 시점 이하에서 안전하게 지울 수 있는 가장 큰 오프셋
val boundary = java.time.Instant.now().minus(java.time.Duration.ofHours(72))
val safeOffset = participant1.pruning.find_safe_offset(beforeOrAt = boundary)

// None이면 그 시점 이하에 안전한 오프셋이 없다는 뜻이다(A.4.4)
safeOffset.foreach(offset => participant1.pruning.prune(offset))
안전 오프셋은 세 가지로 제한됩니다. 상대 participant와 commitment가 일치한 지점, 미결 요청, 최대 중복 제거 기간입니다. 안전하지 않은 지점을 직접 지정하면 UNSAFE_TO_PRUNE으로 거부됩니다. 프루닝된 구간을 읽으려는 Ledger API 요청은 PARTICIPANT_PRUNED_DATA_ACCESSED를 받으므로, 오프셋을 저장해 두고 재개하는 클라이언트가 보존 기간 안에 따라오는지 확인하십시오.
A.4.3 런북: 오프라인 멤버 때문에 순서자 프루닝이 멈췄을 때
맥락. 순서자는 활성 멤버들이 마지막으로 ack한 시각 중 가장 이른 시각까지만 데이터를 지웁니다(A.2.3). 오래 응답하지 않는 멤버가 하나라도 있으면 이 지점이 멈추고 순서자의 스토리지가 계속 늘어납니다.
런북.
- 뒤처진 멤버 찾기.
sequencer1.pruning.status()의 멤버 목록에서 마지막 ack가 가장 오래된 활성 멤버를 찾습니다. 전체 안전 지점은 결과의safePruningTimestamp입니다. - 그 멤버의 운영자에게 연락. 일시적 장애라면 복구를 기다리는 것이 우선입니다. 디스크 여유로 버틸 수 있는 시간을 A.2.3의 모형으로 계산해 기한을 정합니다.
- 복귀하지 않을 멤버만 비활성화. 동기화기 운영 주체의 승인을 받은 뒤
sequencer1.repair.disable_member(member)를 실행합니다. - 프루닝.
sequencer1.pruning.prune()으로 새 안전 지점까지 지웁니다.
// 1. 하한, 현재 시각, 멤버별 등록 시각·마지막 ack·활성 여부
val status = sequencer1.pruning.status()
status.lowerBound
status.safePruningTimestamp
status.members

// 2. 되돌릴 수 없다. 이 멤버는 다시 연결할 수 없고, 다시 활성화하는 명령도 없다.
sequencer1.repair.disable_member(laggingMember)

// 3. 안전 지점까지 프루닝. 다른 형태:
//    prune_at(timestamp), prune_with_retention_period(duration), force_prune(dryRun)
sequencer1.pruning.prune()
주의. disable_member는 되돌릴 수 없습니다. 비활성화된 멤버는 그 순서자에 다시 연결할 수 없고, 읽지 못한 이벤트는 지워집니다. 그 멤버가 participant라면 새 노드로 다시 온보딩하고, 호스팅하던 당사자를 다른 participant로 옮기는 절차(제20장)가 필요합니다. force_prune은 기본 보존 기간까지 지우기 위해, 아직 읽지 않은 멤버를 비활성화합니다. 영향이 같으므로 dryRun = true로 어떤 멤버가 비활성화되는지 먼저 확인하십시오.
이 조치는 순서자의 경계만 움직입니다. participant의 프루닝이 멈춘 원인이 상대 participant의 commitment 미수신이라면 다음 절의 절차를 따로 수행해야 합니다.
A.4.4 런북: commitment 미수신으로 participant 프루닝이 멈췄을 때
맥락. find_safe_offset이 며칠 전 지점에서 전진하지 않거나 None을 돌려줍니다. participant는 상대 participant와 ACS commitment가 일치한 지점까지만 지웁니다. 상대가 오프라인이어서 commitment를 보내지 않으면 그 상대와 공유하는 계약이 있는 한 안전 지점이 멈춥니다.
런북.
- 어느 상대인지 확인.
participant1.commitments.lookup_received_acs_commitments로 상대별 마지막 수신 구간을 봅니다. - 상대 운영자에게 연락. 복구 예정이면 기다립니다.
- 장기 부재가 확인되면 대기 대상에서 제외.
set_no_wait_commitments_from으로 그 상대의 commitment를 기다리지 않도록 설정합니다. - 프루닝 후, 상대가 복귀하면 원복.
set_wait_commitments_from으로 다시 대기 대상에 넣습니다.
// 지정한 동기화기에서 해당 상대의 commitment를 기다리지 않고 프루닝을 진행한다
participant1.commitments.set_no_wait_commitments_from(
  counterParticipants = Seq(offlineParticipantId),
  synchronizerIds     = Seq(synchronizerId),
)

// 상대가 복귀한 뒤 원복
participant1.commitments.set_wait_commitments_from(
  counterParticipants = Seq(offlineParticipantId),
  synchronizerIds     = Seq(synchronizerId),
)
상충. 대기 대상에서 제외하면 그 상대와의 대조 없이 과거 데이터를 지우게 됩니다. 나중에 그 상대와 ACS_COMMITMENT_MISMATCH가 나더라도, 지운 구간에 대해서는 어느 계약이 다른지 추적할 근거가 줄어듭니다. 이 설정은 participant 쪽 설정이고 가역적입니다. 순서자의 disable_member(비가역)와 혼동하지 마십시오.
A.4.5 런북: 미완료 재할당
맥락. 계약을 한 동기화기에서 다른 동기화기로 옮기는 재할당은 unassign과 assign 두 단계입니다. unassign은 원천 동기화기에서 계약을 비활성화하고 재할당 카운터를 올립니다. assign은 대상 동기화기에서 계약을 활성화합니다. unassign이 끝난 뒤 assign이 실행되지 않으면, 계약은 어느 동기화기에서도 활성이 아닌 상태로 남습니다.
메커니즘. 프로토콜에는 일정 시간이 지나면 계약을 원천 동기화기로 되돌리는 자동 롤백이 없습니다. assignmentExclusivityTimeout(기본 60초)은 롤백 시한이 아닙니다. 이 시간 동안에는 재할당을 시작한 쪽만 assign할 수 있고, 그 뒤에는 다른 이해관계자도 대상 동기화기에 assign을 제출할 수 있습니다(이 배타 구간은 프로토콜 버전 36 이하에서만 강제됩니다). assign은 카운터가 unassign 데이터의 값과 같은지 확인합니다. 이미 완료된 재할당을 다시 assign하면 ASSIGNMENT_ALREADY_COMPLETED로 거부됩니다.
런북.
- 미완료 목록 조회. 당사자별로 unassign만 끝난 계약을 조회합니다.
- 원인 제거. 대상 동기화기 연결, 대상 쪽 패키지 vetting(A.4.7), 대상 쪽 당사자 호스팅을 확인합니다.
- assign 제출. 이해관계자 당사자 중 하나로 assign을 제출해 완료합니다.
- 대상 동기화기를 영영 쓸 수 없는 경우. repair 명령으로만 처리할 수 있습니다. 모든 이해관계자의 participant 운영자가 합의하고 각자 같은 조치를 해야 합니다.
// 1. 이 당사자의 계약 중 unassign만 끝난 것
val incomplete = participant1.ledger_api.state.acs.incomplete_unassigned_of_party(party)

// 2. 대상 동기화기에 assign 제출(재할당 ID는 위 결과의 unassign 이벤트에 있다)
participant1.ledger_api.commands.submit_assign(
  submitter      = party,
  reassignmentId = reassignmentId,
  source         = sourceSynchronizerId,
  target         = targetSynchronizerId,
)

// 3. 최후 수단(repair 기능을 켠 상태에서, 두 동기화기와 연결을 끊고 실행):
//    이 participant에서 계약을 원천 동기화기에 다시 할당한다
participant1.repair.rollback_unassignment(
  reassignmentId = reassignmentId,
  source         = sourceSynchronizerId,
  target         = targetSynchronizerId,
)
주의. rollback_unassignment는 프로토콜 동작이 아니라 한 participant의 로컬 상태를 고치는 repair 명령입니다. 이해관계자를 호스팅하는 participant 중 일부만 실행하면 ACS가 서로 어긋나 commitment 불일치가 납니다. par_active_contracts를 SQL로 직접 고치는 것은 어떤 경우에도 하지 마십시오.
A.4.6 런북: 시간 경계 거부
맥락. 특정 participant에서 제출한 트랜잭션이 LOCAL_VERDICT_LEDGER_TIME_OUT_OF_BOUND로 연달아 거부됩니다.
메커니즘. 원장 시각은 제출자가 고릅니다. 확인자는 그 값이 순서자가 붙인 레코드 시각과 ledgerTimeRecordTimeTolerance(기본 60초) 안에 있는지 검사합니다. 제출 participant의 호스트 시계가 어긋나 있으면 제출마다 이 검사에 걸립니다. 준비 시각에는 별도의 허용 오차(preparationTimeRecordTimeTolerance, 기본 24시간)가 적용되고, 벗어나면 LOCAL_VERDICT_PREPARATION_TIME_OUT_OF_BOUND가 납니다.
런북.
- 호스트 시계 확인. 제출 participant의 호스트에서 시간 동기화 상태를 확인합니다(
chronyc tracking등). NTP 서버에 닿지 못하는 방화벽 변경이 흔한 원인입니다. - 동기화기 파라미터 확인. 허용 오차가 기본값에서 바뀌었는지 봅니다.
- 시계 교정 후 재제출. 거부된 명령은 새로 제출해야 합니다.
val params = participant1.topology.synchronizer_parameters
  .get_dynamic_synchronizer_parameters(synchronizerId)

params.ledgerTimeRecordTimeTolerance        // 기본 60초
params.preparationTimeRecordTimeTolerance   // 기본 24시간
params.confirmationResponseTimeout          // 기본 30초
params.mediatorReactionTimeout              // 기본 30초
하지 말아야 할 조치. 시계를 고치는 대신 ledgerTimeRecordTimeTolerance를 크게 늘리지 마십시오. 이 값은 제출자가 원장 시각을 실제 시각과 얼마나 다르게 주장할 수 있는지를 정하므로, 시각에 의존하는 계약 로직(만기, 기한)의 정확도가 그만큼 떨어집니다. 세션 서명 키의 cut-off(A.3.2)도 이 값에 맞춰야 합니다.
A.4.7 런북: vetting·라우팅 오류
맥락. DAR을 올렸는데 제출이 NO_SYNCHRONIZER_ON_WHICH_ALL_SUBMITTERS_CAN_SUBMIT, NO_SYNCHRONIZER_FOR_SUBMISSION, PACKAGE_NOT_VETTED_BY_RECIPIENTS 중 하나로 거부됩니다.
메커니즘. 트랜잭션을 처리하려면 관련된 모든 participant가 그 패키지를 vetting해 두어야 합니다. vetting은 "이 participant가 이 패키지로 만든 트랜잭션을 검증할 준비가 되었다"는 토폴로지 선언입니다. 제출 participant는 트랜잭션의 모든 informee participant가 필요한 패키지를 vetting했고 제출 당사자가 제출 권한을 가진 동기화기를 찾습니다. 그런 동기화기가 없으면 위 오류가 납니다. 한쪽만 DAR을 올린 상태가 가장 흔한 원인입니다.
런북.
// 관련된 모든 participant에서 같은 DAR을 올린다.
// vetAllPackages와 synchronizeVetting의 기본값은 true다.
val mainPackageId = participant1.dars.upload("SyndicatedLoan-1.2.0.dar")
participant2.dars.upload("SyndicatedLoan-1.2.0.dar")

// vetAllPackages = false로 올렸다면 나중에 명시적으로 vetting한다.
// synchronize는 Boolean이고, 동기화기는 별도 인자 synchronizerId로 지정한다.
participant2.dars.vetting.enable(
  mainPackageId,
  synchronize    = true,
  synchronizerId = Some(synchronizerId),
)

// 각 participant가 같은 동기화기에 연결되어 있는지 확인한다.
// 토폴로지에 등록된 vetting 상태는 topology.vetted_packages 그룹의 list로 조회한다.
participant1.synchronizers.list_connected()
participant2.synchronizers.list_connected()
실패 양상. 애플리케이션이 이 오류를 즉시 무한 재시도하면 participant에 불필요한 부하만 줍니다. vetting은 토폴로지 변경이므로 사람이 조치해야 풀립니다. 패키지 업그레이드에서는 새 버전을 상대가 vetting하기 전에 새 버전으로 제출하지 않도록 배포 순서를 정하십시오.
A.4.8 런북: participant HA 페일오버
맥락. participant를 active-passive 복제로 운영합니다. 두 복제본은 같은 DB를 공유하고, DB 잠금을 가진 쪽이 active입니다. active가 멈추면 passive가 잠금을 얻어 active가 됩니다.
메커니즘. passive 복제본은 명령을 받지 않고 PASSIVE_REPLICA로 거부합니다. 로드밸런서는 health 점검(A.5.2)으로 active를 구분해 트래픽을 보냅니다. 여러분의 구성에서 passive 복제본이 health 점검에 어떻게 응답하는지는 전환 훈련에서 직접 확인해 두십시오. 새 active는 DB에 기록된 clean 지점부터 이벤트를 다시 처리하고, 충돌 감지 상태를 재구성한 뒤 요청을 받습니다. 전환 중에 진행되던 요청 가운데 확인 응답이 나가지 못한 것은 판정 시각에 타임아웃됩니다.
런북(계획된 전환).
// 1. 현재 역할 확인
participantA.health.active   // true
participantB.health.active   // false

// 2. 전환 전 진단 자료 확보
participantA.health.dump()

// 3. active를 passive로 내린다. 다른 복제본이 잠금을 얻어 active가 된다.
participantA.replication.set_passive()

// 4. 새 active 확인
utils.retry_until_true(participantB.health.active)
실패 양상. DB 자체가 페일오버하면 두 복제본 모두 연결이 끊겼다가 다시 붙습니다. 이때 어느 쪽이 active가 될지는 잠금을 먼저 얻는 쪽에 달려 있으므로, 로드밸런서가 고정 주소가 아니라 health 상태를 따르도록 해 두어야 합니다. 페일오버 소요 시간은 DB 연결 타임아웃, health 점검 주기, 재처리할 이벤트 양의 합으로 결정됩니다. 정기 훈련으로 측정하십시오.
A.4.9 런북: repair — purge와 ACS import
맥락. 한 participant의 ACS가 상대와 어긋났고(예: ACS_COMMITMENT_MISMATCH), 프로토콜로는 고칠 수 없습니다. repair 명령은 participant의 로컬 상태를 직접 고치는 최후 수단입니다.
전제. repair 명령은 설정에서 기능 플래그(features.enable-repair-commands)를 켜야 쓸 수 있습니다. 실행 중에는 해당 participant를 관련 동기화기에서 분리해 두어야 하고, 명령이 끝날 때까지 다시 연결하면 안 됩니다. 계약 수에 따라 실행 시간이 길어질 수 있습니다. 변경은 repair_counter와 함께 이력으로 남습니다(A.1.8).
// 0. (상대 participant에서) 합의한 오프셋 시점의 ACS를 내보낸다
peerParticipant.repair.export_acs(
  parties        = Set(party),
  ledgerOffset   = agreedOffset,
  exportFilePath = "agreed-acs-export.gz",
)

// 1. 대상 participant를 동기화기에서 분리
participant1.synchronizers.disconnect("mysync")

// 2. 잘못 남아 있는 계약을 비활성화한다.
//    인자: 동기화기 별칭, 계약 ID의 Seq, ignoreAlreadyPurged(기본 true)
participant1.repair.purge(
  synchronizerAlias   = "mysync",
  contractIds         = contractIdsToPurge,
  ignoreAlreadyPurged = true,
)

// 3. 빠진 계약을 내보낸 파일에서 가져온다. 첫 인자는 별칭이 아니라 동기화기 ID다.
participant1.repair.import_acs(
  synchronizerId = synchronizerId,
  importFilePath = "agreed-acs-export.gz",
)

// 4. 다시 연결
participant1.synchronizers.reconnect("mysync")
확인. 다시 연결한 뒤 다음 대조 주기에 commitment가 일치하는지 확인합니다(A.1.4). 일치하지 않으면 purge하거나 import한 집합이 상대와 다르다는 뜻입니다.
주의. repair는 프로토콜의 검증을 거치지 않습니다. 잘못된 계약을 넣으면 그 participant만 다른 상태를 갖게 되고, 이후 그 계약을 쓰는 트랜잭션은 상대에게 거부됩니다. 어떤 계약을 넣고 뺄지는 모든 이해관계자의 participant 운영자가 합의한 목록을 따라야 합니다. 당사자를 다른 participant로 옮기는 용도의 ACS import에는 별도의 전제 조건(온보딩 상태의 호스팅 매핑, 활성화 이전 시점)이 있으며 제20장에서 다룹니다.
A.5 관측성과 분류
이 묶음은 장애를 인지하고 분류하는 수단을 다룹니다. 진단 자료를 남기는 방법, health 엔드포인트가 뜻하는 바, 그리고 오류 ID에서 런북으로 가는 표입니다.
A.5.1 health.dump: 재시작 전에 남기는 진단 자료
맥락. 장애 중인 노드를 곧바로 재시작하면 원인을 찾을 자료가 사라집니다. 스레드 상태, 연결 상태, 미결 요청은 프로세스가 살아 있을 때만 얻을 수 있습니다.
런북. 콘솔의 health.dump()는 로컬 Canton 프로세스와 연결된 원격 노드의 진단 정보를 모아 하나의 파일로 만들고 그 경로를 돌려줍니다. 재시작이나 페일오버 전에 먼저 실행하는 것을 표준 절차로 두십시오.
// 기본 경로에 저장하고 파일 경로를 돌려준다
val dumpFile = participant1.health.dump()

// 경로와 제한 시간을 지정할 수 있다.
// 원격 노드에서 받을 때 gRPC 메시지 크기 오류가 나면 chunkSize를 줄인다.
participant1.health.dump(outputFile = "/var/tmp/participant1-dump.zip")
주의. 덤프에는 설정과 상태 정보가 들어갑니다. 외부에 전달하기 전에 민감 정보가 남아 있지 않은지 직접 확인하고, 사내 반출 절차를 따르십시오. 노드가 응답하지 않아 덤프를 받을 수 없으면 JVM 스레드 덤프와 PostgreSQL의 pg_stat_activity를 따로 남깁니다.
A.5.2 health 엔드포인트의 의미
맥락. 로드밸런서와 오케스트레이터는 포트가 열려 있는지가 아니라 노드가 요청을 처리할 수 있는지를 알아야 합니다.
메커니즘. 노드는 HTTP health 서버와 gRPC health 서비스를 제공합니다. HTTP 서버에는 준비 상태(readiness)와 생존 상태(liveness) 엔드포인트가 따로 있습니다.
| 종류 | 경로 | 쓰임 |
|---|---|---|
| readiness | /health(이전 경로), /health/readiness, /health/ready | 트래픽을 보낼지 결정. 로드밸런서와 readiness probe |
| liveness | /health/liveness, /health/live | 프로세스를 재시작할지 결정. liveness probe |
상태가 serving이면 200, not serving이면 503을 돌려줍니다. 기동 중에 health 서비스가 아직 등록되지 않은 동안에는 not serving으로 보고합니다. participant의 readiness는 저장소와 암호 계층(KMS 포함)을 필수 의존성으로 삼고, 동기화기 연결, 인덱서, commitment 처리 상태를 보조 의존성으로 삼습니다. participant의 liveness는 항상 살아 있음으로 보고됩니다.
설정. monitoring.http-health-server에 주소와 포트를 지정합니다. gRPC health 서비스는 별도 블록으로 켭니다.
canton.participants.participant1 {
  monitoring.http-health-server {
    address = "0.0.0.0"
    port = 10004
  }
}
실패 양상. liveness와 readiness를 같은 경로로 묶으면, 일시적으로 준비되지 않은 노드(이벤트 재처리 중, passive)를 오케스트레이터가 반복해서 재시작합니다. readiness 실패는 트래픽 차단으로, liveness 실패만 재시작으로 연결하십시오.
A.5.3 스토리지 장애의 상태 전이
맥락. DB 연결이 잠깐 끊긴 것과 DB가 장시간 쓸 수 없게 된 것은 대응이 다릅니다. 전자는 재시도로 지나가야 하고, 후자는 노드를 교체하거나 재시작해야 합니다.
메커니즘. 저장소 작업이 실패하면 노드는 재시도하면서 DB_STORAGE_DEGRADATION을 보고합니다. 저장소가 실패 상태로 계속 머무는 시간이 failedToFatalDelay(기본 5분)를 넘으면 상태가 fatal로 올라갑니다. 기준 버전에서 이 승격은 순서자가 쓰는 단일 연결 저장소에만 적용됩니다. 순서자는 저장소를 liveness의 필수 의존성으로 선언하므로, fatal이 되면 liveness가 not serving으로 바뀌고 모니터링 인프라가 순서자를 재시작할 수 있습니다. participant가 쓰는 복제 저장소에는 아직 같은 승격이 적용되지 않습니다.
운영 관점. participant에서는 저장소 장애가 길어져도 liveness가 떨어지지 않습니다. readiness만 바뀝니다. DB_STORAGE_DEGRADATION과 DB_CONNECTION_LOST 로그, 그리고 처리 지점이 전진하지 않는 상태(A.1.5)를 별도 경보로 걸어 두십시오.
A.5.4 분류 매트릭스: 증상에서 런북으로
아래 표는 관측되는 오류 ID나 현상에서 출발해 원인과 런북을 찾는 색인입니다. "먼저 확인"은 원인을 좁히는 첫 질문입니다.
| 오류 ID 또는 현상 | 가능한 원인 | 먼저 확인 | 참조 |
|---|---|---|---|
DB_STORAGE_DEGRADATION, DB_CONNECTION_LOST |
DB 디스크 포화, 연결 풀 고갈, DB 페일오버 | PostgreSQL 디스크 사용률과 연결 수 | A.4.1, A.2.1, A.5.3 |
| 프루닝 후에도 디스크 사용량 유지 | 죽은 튜플이 회수되지 않음, 공간이 운영체제에 반환되지 않음 | 테이블별 죽은 튜플 비율, 마지막 autovacuum 시각 | A.4.2 |
| 순서자 디스크가 계속 증가 | ack하지 않는 활성 멤버 | sequencer.pruning.status()의 멤버별 마지막 ack |
A.4.3, A.2.3 |
find_safe_offset이 전진하지 않음, UNSAFE_TO_PRUNE |
상대 participant의 commitment 미수신, 미결 요청, 중복 제거 기간 | 상대별 마지막 수신 commitment | A.4.4, A.1.7 |
ACS_COMMITMENT_MISMATCH |
한쪽의 repair, 상태 불일치 | 최근 repair 이력, 어느 상대와 어느 구간인지 | A.1.4, A.4.9 |
LOCAL_VERDICT_LOCKED_CONTRACTS 비율 증가 |
같은 계약을 소비하는 요청의 경합, 응답하지 않는 확인자로 인한 긴 잠금 | 어느 템플릿의 계약인지, 타임아웃 판정이 함께 늘었는지 | A.1.2 |
MEDIATOR_SAYS_TX_TIMED_OUT |
확인자 participant가 오프라인이거나 느림, 순서화 정지 | 어느 확인자가 응답하지 않았는지, 순서자 정족수 | A.1.9, A.2.5 |
LOCAL_VERDICT_LEDGER_TIME_OUT_OF_BOUND |
제출 participant의 호스트 시계 오차 | 호스트의 시간 동기화 상태 | A.4.6 |
NO_SYNCHRONIZER_ON_WHICH_ALL_SUBMITTERS_CAN_SUBMIT, PACKAGE_NOT_VETTED_BY_RECIPIENTS |
상대 participant가 패키지를 vetting하지 않음, 공통 동기화기 없음 | 양쪽의 vetting 상태와 연결된 동기화기 | A.4.7 |
| unassign만 끝난 계약이 남아 있음 | 대상 동기화기 연결 끊김, 대상 쪽 vetting 누락 | 미완료 재할당 목록, 대상 동기화기 연결 | A.4.5 |
INVALID_DEDUPLICATION_PERIOD |
클라이언트의 중복 제거 기간이 보존 기간보다 김 | 최근 프루닝 시점과 클라이언트 설정 | A.1.7 |
SEQUENCER_NOT_ENOUGH_TRAFFIC_CREDIT |
트래픽 잔액 부족 | 멤버의 트래픽 상태 | A.2.6 |
PASSIVE_REPLICA |
요청이 passive 복제본으로 감 | 로드밸런서의 health 점검 대상 경로 | A.4.8, A.5.2 |
HEAP_MEMORY_OVER_LIMIT, PARTICIPANT_BACKPRESSURE |
과부하, 한도 설정이 워크로드보다 낮음 | 힙 사용률, 폭주하는 클라이언트가 있는지 | A.2.4 |
SEQUENCER_SUBMISSION_AFTER_UPGRADE_TIME |
업그레이드 시각 이후 이전 동기화기로 제출 | LSU 공지와 후속 동기화기 연결 상태 | A.6.1 |
금융시장인프라 원칙(CPMI-IOSCO PFMI)은 운영 리스크와 관련해 중요 시스템이 장애 후 신속히 복구되고 확정된 거래의 상태를 잃지 않을 것을 요구합니다. 구체적인 복구 목표 수치와 적용 범위는 원문과 관할 감독당국의 지침에서 확인하십시오. 이 부록의 런북은 그 요구를 충족하는 데 필요한 절차의 재료이며, 목표 시간의 달성 여부는 각 기관이 훈련으로 측정해 입증해야 합니다.
A.5.5 감사 요청과 증적 대응표
감독당국이나 내부 감사가 묻는 항목은 관할에 따라 표현이 다르지만 내용은 대체로 겹칩니다. 아래 표는 흔한 요구를 Canton의 메커니즘과 제시할 수 있는 증적에 대응시킨 것입니다. 법규 조문은 관할마다 다르므로 원칙 수준으로만 적었습니다.
| 요구 | 메커니즘 | 제시할 증적 |
|---|---|---|
| 거래 내용이 당사자 외 기관과 인프라 운영자에게 노출되지 않을 것 | 뷰 분해와 수신자별 암호화, 블라인드 처리(A.1.9) | 노드별 관측 데이터 표, 동기화기 운영 주체의 접근 권한 구성 |
| 결제 완결 시점이 확정적일 것 | 순서자 타임스탬프와 중재자 판정, 판정 시각 상한 | 동적 파라미터(타임아웃) 설정 이력, 판정 로그 |
| 장기 키가 애플리케이션 서버 밖에 보관될 것 | KMS 연동, 세션 키의 유효 기간 제한(A.3.1, A.3.2) | KMS 설정과 감사 로그, 세션 키 설정값과 그 근거 |
| 관리 기능이 분리된 경로로만 접근될 것 | Admin API 바인딩 제한, Ledger API 토큰 검증(A.3.4) | 바인딩 주소와 방화벽 규칙, 인증 서버 설정 |
| 개인정보 삭제 요구와 장부 무결성의 양립 | 프루닝으로 과거 데이터 삭제, commitment로 현재 상태 대조 유지 | 프루닝 일정과 보존 기간 정책, commitment 대조 기록. 개인정보를 계약 본문에 직접 넣지 않는 모델링 원칙 |
| 일부 운영 기관의 장애나 악의적 동작을 견딜 것 | BFT 순서자 그룹, 중재자 그룹(A.2.5) | 노드 수와 장애 영역 구성, 결함 주입 훈련 기록 |
| 한 기관의 데이터 손상이 전체 중단으로 번지지 않을 것 | participant 단위 repair와 이력 기록(A.1.8, A.4.9) | 복구 훈련 기록, repair 이력 조회 결과 |
| 업그레이드가 서비스 중단을 최소화할 것 | LSU(A.6.1) | 업그레이드 리허설 기록, 공지와 전환 시각 이력 |
A.6 업그레이드와 배포 선택
이 묶음은 드물게 내리지만 되돌리기 어려운 결정을 다룹니다. 프로토콜 업그레이드 절차, 어떤 구성요소를 배치할지, 운영비를 어떻게 나눌지, 그리고 현재 구조가 과거 구조와 어떻게 다른지입니다. 마지막 두 절은 직접 실행해 볼 수 있는 실습과 적용 사례입니다.
A.6.1 논리적 동기화기 업그레이드(LSU)
맥락. 프로토콜 버전을 올리려면 동기화기의 모든 노드와 연결된 모든 participant가 새 버전으로 넘어가야 합니다. 전체를 멈추고 한꺼번에 바꾸는 방식은 참여 기관이 많을수록 조율이 어렵습니다.
메커니즘. 동기화기에는 논리적 ID와 물리적 ID가 있습니다. LSU는 논리적 동기화기를 유지한 채, 정해진 업그레이드 시각에 현재의 물리적 동기화기에서 후속 물리적 동기화기로 넘어가는 절차입니다. 계약은 논리적 동기화기에 할당되어 있으므로 재할당 없이 그대로 이어집니다.
- 후속 동기화기 준비. 새 프로토콜 버전으로 동작하는 순서자와 중재자를 후속 물리적 동기화기로 구성합니다.
- 업그레이드 공지. 동기화기 소유자들이 후속 물리적 동기화기 ID와 업그레이드 시각을 담은 토폴로지 트랜잭션을 제안하고, 소유자 임계치만큼 서명해 확정합니다.
- participant 준비. 각 participant 운영자는 업그레이드 시각 전에 새 프로토콜 버전을 지원하는 바이너리로 올리고, 후속 동기화기의 순서자에 네트워크로 닿을 수 있는지 확인합니다.
- 전환. 업그레이드 시각이 되면 현재 물리적 동기화기는 새 제출을 받지 않습니다. participant는 후속 동기화기로 넘어가 처리를 계속합니다.
// 동기화기 소유자 노드에서: 후속 물리적 동기화기와 업그레이드 시각을 공지한다.
// 소유자 임계치만큼 서명이 모이면 확정된다.
sequencer1.topology.lsu.announcement.propose(
  successorPhysicalSynchronizerId = successorPsid,
  upgradeTime                     = upgradeTime,
)

// 어느 노드에서든: 확정된 공지 확인
participant1.topology.lsu.announcement.list()
실패 양상. 업그레이드 시각에 진행 중이던 요청은 완료되지 못하고 타임아웃됩니다. 클라이언트는 이를 일반 타임아웃과 같이 처리해 재제출해야 합니다. 업그레이드 시각 이후 이전 물리적 동기화기로 간 제출은 SEQUENCER_SUBMISSION_AFTER_UPGRADE_TIME으로 거부됩니다. 지원하지 않는 프로토콜 버전을 만나 노드가 스스로 정지하는 식의 동작은 없습니다. 준비되지 않은 participant는 후속 동기화기에 연결하지 못한 채 남습니다.
런북. 업그레이드 시각은 거래량이 적은 시간대로 잡고, 판정 시각(기본 60초)보다 충분히 앞서 신규 제출을 줄이도록 애플리케이션 운영자에게 알립니다. 업그레이드 시점에 오프라인이었고 이전 동기화기가 이미 폐기된 participant는 repair 명령 perform_late_lsu로 뒤늦게 전환합니다. 리허설은 운영과 같은 토폴로지의 시험 환경에서 먼저 수행하십시오.
A.6.2 배포 모델: 무엇을 배치할 것인가
맥락. Canton은 원장 프로토콜과 노드(participant, 순서자, 중재자)입니다. Splice는 그 위에서 동작하는 애플리케이션 묶음으로, 탈중앙 동기화기 운영(슈퍼 검증인 거버넌스), amulet, 지갑, 트래픽 구매 자동화를 제공합니다. Canton 설정에 Splice를 켜는 스위치는 없습니다. Splice는 별도 프로세스로 배치하고 participant의 Ledger API에 붙습니다. 그래서 배포 모델은 세 가지로 나뉩니다.
| 기준 | Canton만 쓰는 사설 동기화기 | 사설 Splice 네트워크 | Global Synchronizer 참여 |
|---|---|---|---|
| 적합한 경우 | 정해진 기관들 사이의 결제·담보·대사 | 컨소시엄 안에서 자체 결제 수단과 탈중앙 거버넌스가 필요한 경우 | 불특정 다수 기관과의 상호운용이 필요한 경우 |
| 배치하는 구성요소 | participant, 순서자, 중재자 | 왼쪽에 더해 Splice 앱 전체 | participant와 validator 앱 |
| 동기화기 운영 주체 | 컨소시엄(또는 지정 운영자) | 컨소시엄의 슈퍼 검증인들 | Global Synchronizer의 슈퍼 검증인들 |
| 트래픽 비용 | 토큰 없음. 계량과 분담은 A.6.3 | 자체 발행 단위로 트래픽 구매 | Canton Coin(amulet)으로 트래픽 구매 |
| 거버넌스 | 컨소시엄 협약과 토폴로지 소유자 임계치 | 원장 위 규칙 계약에 대한 슈퍼 검증인 투표 | Global Synchronizer의 거버넌스 절차 |
한 participant는 여러 동기화기에 동시에 연결할 수 있으므로, 세 모델은 배타적이지 않습니다. 사설 동기화기에서 발행한 자산을 공용 동기화기의 결제 수단과 함께 쓰려면 재할당(A.4.5)으로 계약을 옮깁니다.
설정. 노드 종류마다 필요한 설정 블록이 다릅니다.
| 설정 블록 | participant | 순서자 | 중재자 |
|---|---|---|---|
storage | 필요(ACS, 이벤트, 인덱서) | 필요(순서화된 이벤트, BFT 계층 상태) | 필요(요청과 판정 상태) |
ledger-api와 인증 | 필요 | 없음 | 없음 |
public-api | 없음(순서자에 클라이언트로 접속) | 필요(participant와 중재자가 접속) | 없음(순서자에 클라이언트로 접속) |
admin-api | 필요 | 필요 | 필요 |
crypto(KMS 포함) | 필요 | 필요 | 필요 |
monitoring | 필요 | 필요 | 필요 |
| 종류별 조정 항목 | 인덱스 서비스, 캐시, 프루닝 일정 | BFT 피어 구성, 트래픽 제어, 프루닝 | 프루닝 |
산정. 사설 동기화기의 토폴로지는 신뢰 관계에서 정해집니다. 운영자 한 곳을 모두가 신뢰하면 순서자를 그 운영자가 맡고, 가용성만을 위해 다중화합니다. 서로를 신뢰하지 않는 기관들이 공동 운영하면 기관마다 순서자를 하나씩 두는 BFT 구성으로 가고, 노드 수는 A.2.5의 식으로 정합니다. 한 그룹 안의 지역별 법인처럼 신뢰가 같은 주체들은 지역마다 동기화기를 따로 두고 재할당으로 잇는 구성도 가능합니다.
A.6.3 토큰 없는 비용 모델
맥락. 사설 동기화기에는 토큰이 없습니다. 그래도 운영비(인프라, 인력)는 발생하고, 한 멤버가 공유 자원을 독점하지 못하게 할 장치도 필요합니다.
메커니즘. 트래픽 제어(A.2.6)는 토큰과 무관하게 동작합니다. 순서자는 멤버별로 소비한 트래픽을 바이트 단위로 계량하고, 동기화기 운영 주체는 멤버별 추가 트래픽을 직접 할당할 수 있습니다. 이 계량 결과가 비용 분담의 근거 자료가 됩니다. 분담 방식은 프로토콜이 아니라 컨소시엄 협약으로 정합니다. 흔한 선택지는 세 가지입니다.
- 정액 분담. 운영비를 멤버 수로 나눕니다. 단순하지만 사용량이 크게 다른 멤버 사이에서 불만이 생깁니다.
- 사용량 비례. 계량된 트래픽에 비례해 나눕니다. 공정하지만 예산 예측이 어렵습니다.
- 혼합. 고정 회비로 기본 트래픽을 주고, 초과분만 사용량에 따라 청구합니다.
Global Synchronizer에서는 추가 트래픽을 따로 구매하며, 가격은 MB당 단가로 정해집니다. 과거에 있던 거래별 수수료(생성 수수료, 구간별 전송 수수료, 잠금 보유 수수료)는 없어졌고 보유 수수료만 남았습니다. 보유 수수료는 라운드마다 일정액이 줄어드는 선형 방식입니다.
런북. 멤버별 트래픽 상태는 sequencer.traffic_control.traffic_state_of_members로 조회하고, 운영 주체가 잔액을 설정할 때는 같은 그룹의 set_traffic_balance를 씁니다. 정산 주기마다 이 값을 내보내 보관하십시오.
A.6.4 Splice 구성요소, 자동화, 읽기 정족수
맥락. Splice를 배치하거나 Global Synchronizer에 참여하면 Canton 노드 외에 Splice 앱을 운영하게 됩니다. 각 앱이 어떤 권한을 갖고 어디에 놓여야 하는지 알아야 네트워크 경계를 정할 수 있습니다.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
| 앱 | 누가 운영 | 행사하는 당사자 권한 | 원장 사용 형태 | 배치 |
|---|---|---|---|---|
| Scan | 슈퍼 검증인 | 읽기 위주 | 원장 업데이트를 구독해 네트워크 공용 상태(라운드, 규칙, 트래픽)를 HTTP로 제공 | 외부 요청을 받는 구역. 수평 확장 대상 |
| Validator | 네트워크의 모든 참여 기관 | 검증인 운영 당사자, 위임받은 사용자 당사자 | 트래픽 잔량 확인과 구매, 사용자 온보딩, 지갑 백엔드 기능 | 내부망. participant 옆 |
| SV | 슈퍼 검증인 | 슈퍼 검증인 당사자, DSO 당사자의 공동 호스팅 | 라운드 진행 자동화, 거버넌스 투표의 집계와 집행 | 가장 제한된 구역 |
| Splitwell | 앱 제공자 | 앱 제공자 당사자 | 참조용 예제 애플리케이션 | 앱 제공자의 내부망 |
지갑과 이름 서비스 화면은 validator 앱의 API를 쓰는 프런트엔드입니다. 구성요소를 나누는 이유는 권한 분리입니다. 외부 요청을 직접 받는 Scan이 침해되더라도, Scan에는 명령을 제출할 당사자 권한이 없으므로 원장 상태를 바꿀 수 없습니다. 영향은 잘못된 읽기 응답으로 한정되고, 그것은 아래의 읽기 정족수로 걸러냅니다.
메커니즘 1: 원장 밖 자동화. Daml 계약에는 타이머가 없습니다. 계약은 누군가 명령을 제출할 때만 상태가 바뀝니다. 모든 participant가 같은 결과를 재계산해야 하므로, 계약 코드가 각자의 벽시계를 읽거나 스스로 실행을 시작할 수 없기 때문입니다. "정해진 시각에 라운드를 넘긴다" 같은 동작은 원장 밖의 자동화(SV 앱의 트리거)가 조건을 감시하다가 명령을 제출해서 일어납니다.
여러 슈퍼 검증인의 자동화가 같은 조건을 동시에 감지하면 같은 계약을 소비하는 명령이 여러 개 제출됩니다. 순서자가 순서를 정하고, 첫 번째만 성공합니다. 나머지는 LOCAL_VERDICT_LOCKED_CONTRACTS, LOCAL_VERDICT_INACTIVE_CONTRACTS, 또는 CONTRACT_NOT_FOUND로 거부됩니다. 자동화는 이 거부를 "다른 노드가 이미 처리함"으로 해석하고 재시도 없이 다음 상태를 기다려야 합니다. 권한이 없는 participant가 같은 자동화를 돌려도 결과는 달라지지 않습니다. choice의 controller가 아닌 당사자의 제출은 Daml 권한 검사에서 DAML_AUTHORIZATION_ERROR로 거부됩니다.
메커니즘 2: 거버넌스 투표 임계치. 네트워크 규칙의 변경은 제안 문서(CIP) 논의를 거친 뒤, 원장 위 규칙 계약에 대한 슈퍼 검증인 투표로 확정됩니다. 투표는 슈퍼 검증인 이름을 키로 하는 맵에 기록되고, 필요한 표 수는 다음 식으로 정해집니다.
Scan에서 읽은 값을 신뢰하려면 서로 다른 슈퍼 검증인의 Scan에서 같은 응답을 다음 수만큼 받아야 합니다
예시 수치.
- \(N = 4\)이면 \(f = 1\), \(Q_{\text{vote}} = 3\), \(Q_{\text{read}} = 2\)입니다.
- \(N = 13\)이면 \(f = 4\), \(Q_{\text{vote}} = 9\), \(Q_{\text{read}} = 5\)입니다.
같은 응답 \(f + 1\)개 중 적어도 하나는 정직한 노드에서 왔으므로, 그 값은 정직한 노드가 본 값입니다. 흔히 인용되는 \(\lfloor 2N/3 \rfloor + 1\)은 Splice의 투표 임계치가 아닙니다.
운영 관점. validator 앱이 Scan을 하나만 조회하도록 구성하면 그 Scan 운영자를 전적으로 신뢰하게 됩니다. 프로덕션에서는 여러 슈퍼 검증인의 Scan을 조회하는 BFT 읽기 구성을 쓰십시오. 토큰 표준(CIP-0056)의 인터페이스는 Holding, TransferFactory/TransferInstruction, AllocationFactory/Allocation/AllocationInstruction, AllocationRequest이며 본편 제5부에서 다룹니다. 개별 CIP의 번호와 내용은 이 부록에서 인용하지 않습니다. 필요한 경우 CIP 저장소의 원문을 확인하십시오.
A.6.5 저장소와 순서화 계층의 변천
맥락. 오래된 자료나 과거 배포를 보면 지금은 없는 구성이 나옵니다. 여러 종류의 데이터베이스 백엔드, 그리고 외부 원장을 순서화 계층으로 쓰는 순서자입니다. 과거 구조를 현재 구조로 옮겨야 하는 팀은 무엇이 왜 바뀌었는지 알아야 합니다.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
| 계층 | 과거 구조 | 현재 구조 | 운영상 차이 |
|---|---|---|---|
| 저장소 | PostgreSQL과 상용 RDBMS를 함께 지원 | PostgreSQL이 운영 표준. 메모리 저장소와 H2는 시험용 | 스키마를 PostgreSQL의 저장 방식에 맞출 수 있음(A.1.1). 지원할 조합이 줄어 시험 범위가 좁아짐 |
| 순서화 | 외부 원장(EVM 계열, Fabric 등)을 드라이버로 연결 | 순서자에 내장된 BFT 순서화 계층(sequencer.type = BFT) |
별도 원장 노드를 운영하지 않음. 순서화 계층의 합의와 Canton 프로토콜 사이의 변환 단계가 없어짐 |
| 운영 대상 | Canton 프로세스, 외부 원장 노드, 데이터베이스 | Canton 프로세스와 PostgreSQL | 장애 영역과 업그레이드 조율 대상이 줄어듦 |
| 확장 지점 | 백엔드별 전용 통합 | 순서자 드라이버 인터페이스 | 다른 순서화 백엔드를 붙일 경로는 남아 있음 |
메커니즘. 외부 원장을 순서화 계층으로 쓰면 Canton 메시지를 그 원장의 트랜잭션 형식으로 감싸 제출하고, 그 원장의 합의가 끝난 뒤 다시 풀어야 합니다. 순서화 처리량과 지연은 외부 원장의 합의 특성에 묶이고, 그 원장의 장애가 곧 동기화기의 장애가 됩니다. 내장 BFT 순서화 계층은 여러 리더가 병렬로 블록을 제안하는 구조이며(A.2.5), Canton의 메시지 형식과 트래픽 계량을 직접 다룹니다.
처리량 수치는 싣지 않습니다. 순서화 처리량은 노드 수, 네트워크 지연, 메시지 크기, 디스크 성능에 따라 크게 달라지므로, 대상 토폴로지에서 직접 측정한 값만 설계 근거로 쓰십시오.
이전 시 확인할 것. 과거 구조에서 넘어올 때는 데이터베이스 이전과 순서화 계층 교체가 별개 작업입니다. 순서화 계층을 바꾸는 것은 동기화기를 바꾸는 것이므로, 계약을 새 동기화기로 옮기는 계획(재할당 또는 ACS 내보내기와 가져오기)이 따로 필요합니다.
A.6.6 실습: 로컬 4노드 BFT 동기화기
목적. A.2.5의 정족수 식을 직접 확인합니다. 순서자 4대(\(f = 1\), 강한 정족수 3)로 동기화기를 만들고, 순서자를 하나씩 멈추면서 participant 사이의 ping이 어떻게 되는지 봅니다. 로컬 시험용 구성이며 운영 구성이 아닙니다.
canton {
  sequencers {
    sequencer1 {
      # 정지·재시작 실험을 하므로 순서자는 영속 저장소를 쓴다.
      # 메모리 저장소는 노드를 정지하면 상태를 잃는다.
      storage {
        type = postgres
        config.properties {
          serverName = "localhost"
          portNumber = 5432
          databaseName = "lab_sequencer1"
          user = "canton"
          password = ${?POSTGRES_PASSWORD}
        }
      }
      public-api.port = 5001
      admin-api.port = 5002
      sequencer {
        type = BFT
        config.initial-network {
          server-endpoint {
            address = "0.0.0.0"
            port = 31030
            external-address = "127.0.0.1"
            external-port = 31030
            external-tls-config.enabled = false
          }
          # 나머지 세 순서자의 P2P 엔드포인트
          peer-endpoints = [
            { address = "127.0.0.1", port = 31031, tls-config.enabled = false },
            { address = "127.0.0.1", port = 31032, tls-config.enabled = false },
            { address = "127.0.0.1", port = 31033, tls-config.enabled = false }
          ]
          endpoint-authentication.auth-token = {}
        }
      }
    }
    # sequencer2..4: 같은 구조. 데이터베이스 이름, API 포트, P2P 포트(31031..31033)를 바꾸고,
    # peer-endpoints에는 자신을 뺀 나머지 셋을 적는다.
  }
  mediators {
    mediator1 { storage.type = memory, admin-api.port = 5202 }
    mediator2 { storage.type = memory, admin-api.port = 5212 }
  }
  participants {
    participant1 { storage.type = memory, ledger-api.port = 5301, admin-api.port = 5302 }
    participant2 { storage.type = memory, ledger-api.port = 5311, admin-api.port = 5312 }
  }
}
val seqs = Seq(sequencer1, sequencer2, sequencer3, sequencer4)

bootstrap.synchronizer(
  synchronizerName   = "lab",
  sequencers         = seqs,
  mediators          = Seq(mediator1, mediator2),
  synchronizerOwners = seqs,
  // 토폴로지 변경에 필요한 소유자 서명 수다. BFT 정족수가 아니다.
  synchronizerThreshold = PositiveInt.tryCreate(3),
  staticSynchronizerParameters =
    StaticSynchronizerParameters.defaults(ProtocolVersion.forSynchronizer),
)

// 두 participant를 네 순서자 모두에 연결한다
participant1.synchronizers.connect_local_bft(sequencers = seqs, synchronizerAlias = "lab")
participant2.synchronizers.connect_local_bft(sequencers = seqs, synchronizerAlias = "lab")
participant1.health.ping(participant2)   // 기준선: 성공

// 실험 1: 1대 정지(응답 3대 = 강한 정족수). 순서화가 계속된다.
sequencer4.stop()
participant1.health.ping(participant2)   // 기대: 성공

// 실험 2: 2대 정지(응답 2대 < 3). 순서화가 멈춘다.
sequencer3.stop()
// 기대: ping이 제한 시간 안에 끝나지 않고 실패한다.
// 서로 다른 순서가 확정되는 일은 없다. 진행이 멈출 뿐이다.

// 실험 3: 1대 복구(응답 3대). 순서화가 재개된다.
sequencer4.start()
participant1.health.ping(participant2)   // 기대: 성공
읽는 법. bootstrap.synchronizer의 인자 가운데 두 가지를 구분하십시오. synchronizerThreshold는 동기화기 소유자들이 토폴로지 변경(파라미터 변경, 업그레이드 공지)을 승인할 때 필요한 서명 수입니다. BFT 순서화 계층의 정족수는 인자로 주는 값이 아니라 순서화에 참여하는 순서자 수에서 A.2.5의 식으로 정해집니다. 중재자는 mediators에 목록으로 넘기고, 중재자 그룹의 임계치는 선택 인자 mediatorThreshold(기본 1)로 정합니다.
관찰할 것. 실험 2에서 로그에 무엇이 남는지, 실험 3에서 복구된 순서자가 밀린 블록을 따라잡는 데 얼마나 걸리는지 기록해 두십시오. 메트릭 daml.sequencer.bftordering.p2p.endpoint-status의 변화도 함께 봅니다. 중재자를 하나 멈추는 실험도 해 보십시오. 중재자 그룹 임계치가 1이면 남은 하나로 판정이 계속됩니다.
A.6.7 적용 사례: 자격 검증 컨소시엄
맥락. 금융이 아닌 영역에도 같은 구조를 쓸 수 있습니다. 대학, 직업 훈련 기관, 고용주가 지원자의 자격을 검증하는 경우를 봅니다. 요구는 세 가지입니다. 발급 기관이 서명한 자격만 인정될 것, 각 기관이 자기와 무관한 정보를 보지 않을 것, 기관들이 서로에게 인바운드 포트를 열지 않을 것.
삽화 구성 및 생성 프롬프트 보기 열기 / 닫기
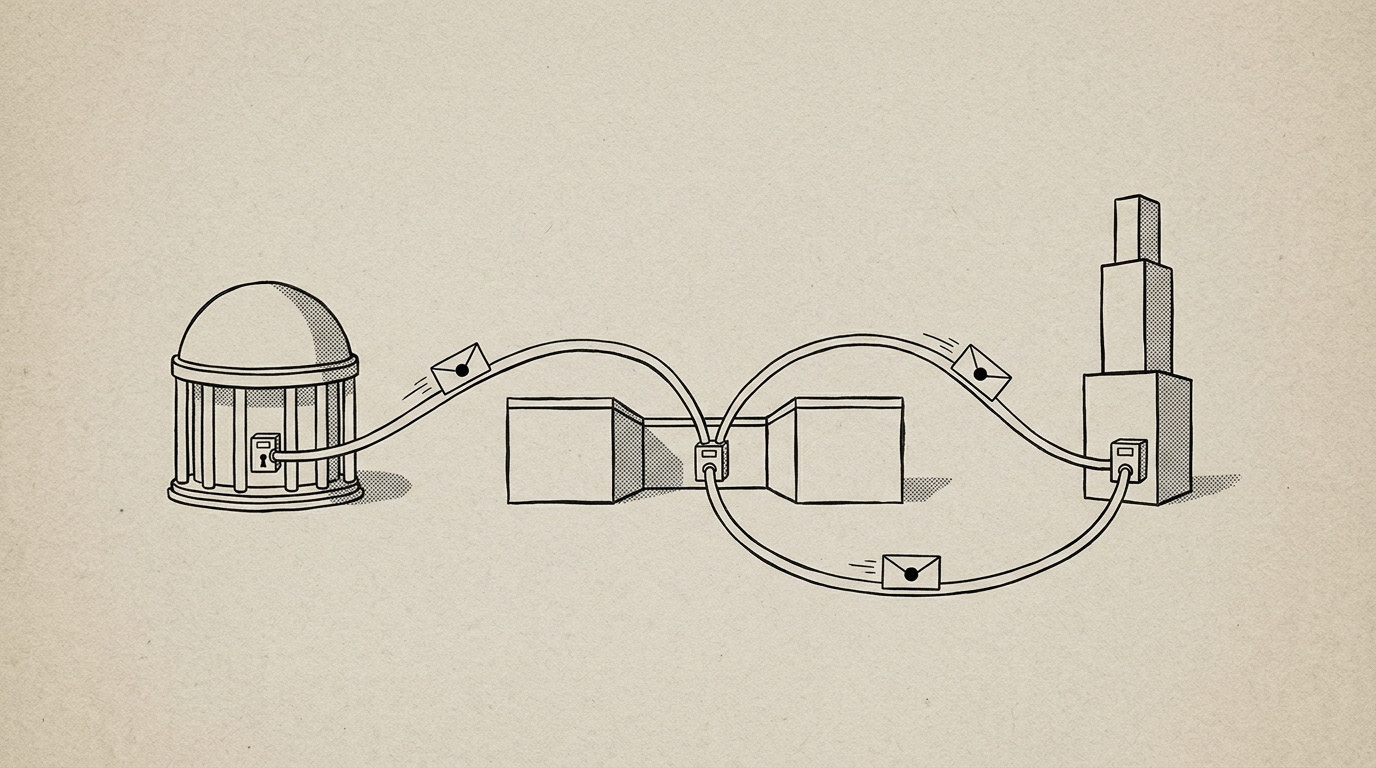
네트워크. 각 기관은 자신의 participant를 운영하고, participant는 동기화기의 순서자에 클라이언트로 접속합니다. 기관의 내부 시스템(학사 DB, 수강 관리, 인사 시스템)은 자기 participant의 Ledger API에만 연결합니다. 기관 사이에는 직접 연결이 없으므로, 다른 기관을 위해 인바운드 포트를 열 필요가 없습니다. 외부에 공개되는 것은 순서자의 public API뿐입니다.
모델. 아래는 설명용 모형입니다. 점수는 0–100 범위의 일반 점수로, 제안 금액은 금액과 통화 코드로 표현했습니다.
module CredentialVerification where

-- 대학이 발급하는 학위 증명. 지원자만 관찰자다.
template UniversityDegree
  with
    university     : Party
    candidate      : Party
    major          : Text
    score          : Decimal   -- 0.0 – 100.0
    transcriptHash : Text
  where
    signatory university
    observer  candidate
    ensure    score >= 0.0 && score <= 100.0

    -- 지원자가 특정 고용주에게 공개한다. 대학과 지원자가 서명자인 사본이 생긴다.
    nonconsuming choice DiscloseToEmployer : ContractId DisclosedDegree
      with employer : Party
      controller candidate
      do
        create DisclosedDegree with university; candidate; employer; major; score; transcriptHash

template DisclosedDegree
  with
    university     : Party
    candidate      : Party
    employer       : Party
    major          : Text
    score          : Decimal
    transcriptHash : Text
  where
    signatory university, candidate
    observer  employer

-- 훈련 기관이 발급하는 수료 증명
template TrainingCertificate
  with
    provider     : Party
    candidate    : Party
    employer     : Party
    trackName    : Text
    projectScore : Int
  where
    signatory provider, candidate
    observer  employer
    ensure    projectScore >= 0 && projectScore <= 100

-- 지원서. 고용주가 두 증명을 한 트랜잭션에서 확인하고 제안을 만든다.
template Application
  with
    candidate          : Party
    employer           : Party
    expectedUniversity : Party
    expectedProvider   : Party
    degreeCid          : ContractId DisclosedDegree
    certificateCid     : ContractId TrainingCertificate
  where
    signatory candidate
    observer  employer

    choice VerifyAndExtendOffer : ContractId EmploymentOffer
      with
        offeredAmount : Decimal
        currency      : Text      -- ISO 4217 코드, 예: "USD"
      controller employer
      do
        degree      <- fetch degreeCid
        certificate <- fetch certificateCid
        assertMsg "degree issuer or holder mismatch"
          (degree.university == expectedUniversity && degree.candidate == candidate)
        assertMsg "certificate issuer or holder mismatch"
          (certificate.provider == expectedProvider && certificate.candidate == candidate)
        assertMsg "score below threshold" (degree.score >= 70.0)
        assertMsg "offer must be positive" (offeredAmount > 0.0)
        create EmploymentOffer with
          employer; candidate; offeredAmount; currency
          verifiedMajor = degree.major
          verifiedTrack = certificate.trackName

template EmploymentOffer
  with
    employer      : Party
    candidate     : Party
    offeredAmount : Decimal
    currency      : Text
    verifiedMajor : Text
    verifiedTrack : Text
  where
    signatory employer, candidate
권한. VerifyAndExtendOffer의 본문은 지원서의 서명자(지원자)와 choice의 controller(고용주)의 권한으로 실행됩니다. EmploymentOffer의 서명자가 정확히 이 둘이므로 생성이 허용됩니다. 두 fetch는 고용주가 각 증명의 관찰자여서 가능합니다. 발급 기관이 서명하지 않은 증명은 원장에 존재할 수 없으므로, 계약 ID로 가져왔다는 사실이 곧 발급 기관의 서명을 확인한 것입니다.
누가 무엇을 보는가. 이 모델에서 각 기관이 보는 범위는 다음과 같습니다. 모델을 바꾸면 이 표도 바뀌므로, 설계 검토 때 표를 다시 작성하십시오.
| 기관 | 보는 것 | 보지 못하는 것 |
|---|---|---|
| 대학 | 자신이 발급한 학위, 공개 사본(DisclosedDegree)과 그 안의 고용주, 검증 시 그 사본이 조회되었다는 사실 |
훈련 기관의 수료 증명, 지원서, 제안 금액 |
| 훈련 기관 | 자신이 발급한 수료 증명과 그 안의 고용주, 검증 시 그 증명이 조회되었다는 사실 | 학위와 점수, 지원서, 제안 금액 |
| 고용주 | 자신에게 공개된 학위 사본과 수료 증명, 지원서, 자신이 만든 제안 | 지원자가 다른 고용주에게 공개한 내용 |
| 동기화기 노드 | 송수신자, 메시지 크기, 시각(A.1.9) | 모든 계약 내용 |
설계상 주의. 이 모델에서 대학은 DisclosedDegree의 서명자이므로 지원자가 어느 고용주에게 학위를 공개했는지 알게 됩니다. 대학에도 이를 숨겨야 한다면 모델을 바꿔야 합니다. 예를 들어 지원자가 원본 학위 계약을 원장 밖 경로로 고용주에게 전달하고, 고용주가 그것을 명시적 공개(explicit disclosure)로 제출에 첨부하는 방식입니다. 이 경우에도 계약의 진위는 계약 ID 인증으로 확인됩니다. 계약 ID는 접두 바이트 0x00, 32바이트 discriminator, suffix로 이루어지고, suffix는 버전 접두사 ca 12와 계약 인스턴스를 덮는 해시로 구성됩니다. 내용을 바꾸면 ID가 달라지므로, 첨부된 계약이 그 ID와 맞지 않으면 검증에서 거부됩니다. 어떤 방식을 택하든 "누가 서명자이고 누가 informee인가"가 곧 "누가 보는가"이므로, 프라이버시 요구는 템플릿의 당사자 구성으로 표현해야 합니다.
부록 요약: 운영 전 점검 항목
- 경계를 구분합니다. 순서자 프루닝은 활성 멤버의 ack로, participant 프루닝은 commitment·미결 요청·중복 제거 기간으로 따로 제한됩니다. 한쪽 조치가 다른 쪽을 풀어 주지 않습니다.
- 기본값을 알고 바꿉니다. ack 주기 1분, 팬아웃 버퍼 1100, gRPC 수신 한도 10MB, 세션 서명 키 비활성(유효 5분), 세션 암호화 키 캐시 10초, 원장 시각 허용 오차 60초, 판정 시각 60초. 바꿀 때는 근거와 상충을 기록합니다.
- 되돌릴 수 없는 명령을 표시해 둡니다. 순서자의
disable_member와force_prune은 비가역입니다. repair 명령은 프로토콜 검증을 거치지 않으므로 이해관계자 전원의 합의가 전제입니다. - Canton 테이블을 SQL로 고치지 않습니다. 상태를 바꿔야 하면 콘솔 명령을 쓰고, 그 전에
health.dump()로 자료를 남깁니다. - 노드 수는 장애 영역으로 셉니다. BFT 순서자는 \(N = 3f + 1\)로 잡고, 운영 주체와 인프라가 독립인지 확인합니다.
- 수치는 측정합니다. 이 부록의 산정식은 출발점입니다. 처리량, 복구 시간, KMS 비용은 대상 환경에서 측정하거나 제공자 자료에서 확인한 값만 설계 근거로 씁니다.